RSTSR 第一次报告
RSTSR 程序:基于 Python Array API 发展的 Rust 高维张量数据结构处理程序草案
摘要
编写科学计算程序时,数据的储存结构、以及如何利用该数据结构进行高效计算,是重要与基础的问题,且需要在早期规划。如今,以 NumPy、PyTorch 几乎成为高维张量数据结构的事实标准;后者也在异构编程上提供了相对统一的接口。但在 Python 以外的语言中,除了 C++ 下 LibTorch 库以外,其他语言鲜有对高维张量和异构编程同时的支持。我们希望 RSTSR 程序未来可以解决 Rust 语言下上述困境。目前的 RSTSR 程序基于 Python Array API 标准 (NumPy API 子集),已正确实现了部分重要的高维张量运算与操作,并暴露了一部分接口,为高性能 CPU 计算、与 GPU 计算作准备。但对于重新实现 CPU 上实现大多数计算化学关心的问题的目标,以目前进度仍需要 5–10 周;CUDA 的支持则可能需要更多时间和精力。本文档将 1) 对现有矩阵或张量库作简要现状分析;2) 阐述 Rust 下张量库 RSTSR 的现实意义与目标;3) 对 RSTSR 已经实现的功能作技术说明。
该文档由原始的 typst 报告,经由 AI 转录到 mdx 格式。该转录过程由 Deepseek-v4-flash 完成。
该文档是早期文档,并不反应当前 RSTSR 设计架构与使用方法。
1. 现有矩阵或张量库现状分析
1.1. 计算化学程序使用的矩阵或张量库
我们编写张量库,可以是为科学计算群体、甚至机器学习与视觉渲染群体作贡献;但归根到底,我们的目标仍然是服务于计算化学程序。为此,我们简单回顾计算化学所使用的矩阵或张量库。
| 量化软件 | 张量或现代库 | 研发情况 |
|---|---|---|
| Q-Chem | libtensor | 团队开发,张量缩并与对称化,开源 |
| liblas | BLAS/cuBLAS 封装 | |
| libmathtools | 团队开发,早期矩阵、张量库 | |
| PySCF | NumPy | 外部库,矩阵与张量数乘、矩阵乘 |
| SciPy | 外部库,矩阵线性代数 | |
np_helper | 库作者开发,NumPy 功能的补充,开源 | |
| TBLIS | 外部库,张量缩并,开源 | |
| Psi4 | libmints/matrix | 团队开发,矩阵运算,开源 |
| Psi4NumPy | opt_einsum, NumPy | 库作者开发,张量缩并,开源 |
| MPQC | MADNESS | 团队开发,张量缩并与微分方程,开源 |
这张表格只能表明有过粗略的程序调研,不见得能说明任何问题:
- Q-Chem 开发跨度很大,该程序从 95' 年代发展至今,有许多老旧但仍然堪用的程序 (如
ccman),也有libtensor以现代 C++ 开发的功能完善的张量库 (如ccman2);不同程序使用的张量或线性代数库完全不同,且没有统一的程序规范、代码质量上下限方差很大。 - PySCF 在设计之初并没有对效率与大体系下算法作深度优化,但在小体系上可以做到高效的实现。这可以通过 Python/C binding,从 Python 拆分出效率瓶颈代码转移到 C 实现。事实上,我在 RI-MP2 极化率计算的工作中,就用到了类似技巧。
- Psi4 在对 NumPy 的性能提升、以及张量缩并规范上下的功夫相当多,但这些工作并没有真的引入到 Psi4 的 C++ 主程序中,而是从 Psi4NumPy 教学项目派生出来的。Psi4 程序的效率确实很高,但该程序没有统一的张量库,而是在具体任务 (如
occ) 中分别处理各自的张量缩并问题。 - MPQC 恐怕是已经事实上结束维护的计算化学程序,它不是成功的项目。但 E. Valeev 仍然在积极开发 libint 与 TiledArray。
- CP2K 曾经自主开发过 libsmm,但后来让位于 Intel 开发的 libxsmm。后者不仅可以用于 DFT 计算,而且也是 CPU 下以 CNN 为代表的机器学习方法的重要实现工具。
- 还有很多程序我并不了解,特别是大规模使用 MPI (如 FHI-Aims, ORCA, VASP) 或 GPU (如 TerraChem) 的程序。
但其中的共性是,
- 几乎所有成功的现代计算化学程序,都有对张量计算的强大支持。
1.2. PySCF 使用特色及其对 Rust 程序开发的启发
每个计算化学程序都有其不同的秉性;没有计算化学程序真正地在如何使用数学库的问题上达成一致 (当然,没有一致的问题还包括程序的构造与接口、输入输出文件的格式、算法等等)。
也许现在最成功的分子体系计算化学程序是 ORCA,但这也许可以归因于
- 其论坛式社区的维护;
- 完善的程序手册和较少的程序错误;
- 相对 Gaussian 完整的程序功能,但相当程度的性能提升;
- 免费使用与方便的安装策略、多平台的可用性。
但从开发者的角度,ORCA 绝非好的选择,特别是它非开源的特性。在开源程序中,目前最成功的程序是 PySCF。其归因固然有 PySCF 开发者本身的特色:
- 清晰的代码逻辑 (Python) 与性能关键 (C) 分离的策略;
- 易用性导向 (非性能导向或可承载体系大小导向);
- 突破性地将计算化学程序设计为库,而非主程序控制;这对计算化学方法开发者非常关键,也方便一些对计算过程定制化需求较高的用户;
- 灵活使用面向对象与函数式编程特性,以接口易用性为重,避免复杂继承;
但还有许多特性并非是 PySCF 开发者的工作所致,而是他们的选择所致:
- NumPy 几乎是目前中等规模稠密张量计算的标准 (比机器学习、游戏引擎与渲染等任务的矩阵大,但不需要跨节点并行),这降低了开发者的学习成本,并且其代码编写难度小、易读性高;
- Python 作为脚本语言,可以即时运行与调试,不需要花大量时间编译试错。
我们在选择 Rust 开发时,不可避免地会舍去一些 PySCF 优势的部分,特别是 Python 作为脚本语言的优势;但希冀换来的 (或可以换来的) 是
- 程序运行效率;
- 程序稳定性与更低的内存开销 (避免因程序编写或语言本身导致的内存泄漏);
- 更易于分发的二进制文件;
- 更少的 FFI (不同语言的交互),更便捷的跨平台 (跨操作系统);
相对于 C++ 等其他语言,Rust 在工程规范与部署上也有更大的优势:
- Cargo 方便的构建 (build)、测试 (test)、风格 (rustfmt)、代码规范 (clippy)、覆盖度 (tarpaulin)、预编译选项 (feature);但文档 (doc) 可能是目前 Cargo 的弱项;
- 出于 Rust 严格的代码规范,只要编译不出现错误,我们可以放心地处理复杂生命周期与 Trait 组合。
相对地,Rust 必然会舍去的其他语言的优点 (也可能是缺点) 包括
- Rust 不是脚本语言,无论是否有 Jupyter 开发环境 (evcxr),这一定是不方便的;
- Rust 不支持像 C++ 非常自由的模板具体化,这可以规范代码,但也让 lazy evaluation (惰性求值)、需要编译时计算得到的类型推导变得困难。
1.3. NumPy 特色与其在计算化学中的关联
在我看来,PySCF 的成功不仅是其开发者自身的努力所致,也是借了 Python 与 NumPy 的东风。我们可以用具体的例子表明 NumPy 在计算化学中应用;并藉此反观,作为程序开发者,我们到底对数学库可能有怎样的期待。
-
高维度张量
这在计算化学中经常使用,特别是涉及到 CC 方法的算法。
-
Broadcasting
D = (+ eo[:, None, None, None] + eo[None, :, None, None]- ev[None, None, :, None] - ev[None, None, None, :])这段代码未必会用于实际的 MP2 能量计算,因为它对内存大小的需求较大。但 MP2 在 Python 的实现可以通过三行代码做到;当性能不是关键部分时,这样的代码非常直观。类似地,在 Laplace-Transform OS-MP2 中,我们也会用到乘法的 Broadcasting:
grid_exp = np.exp(D_ia * grid_points[:, None, None])类似的情况,在 DFT 格点积分也较为普遍。
-
连续内存下的维度转变
下述问题尽管可以用 Einstein summation / einops 实现,按理 einops 需要满足下述计算需求。但 einops 高效实现有困难,需要投入较大精力;如果没有 einops,那么最好的做法是变换维度后作矩阵乘法:
T, t = [tsr.reshape(nocc, nocc * nvir**2) for tsr in (T, t)]rdm2[so, so] = -2 * T @ t.TT, t = [tsr.reshape(nocc**2 * nvir, nvir) for tsr in (T, t)]rdm2[sv, sv] = 2 * T.T @ TT = T.reshape(nocc * nvir, nocc * nvir)Gamma = Y @ T上述的
np.reshape函数需要从 4-d 张量变换到 2-d 矩阵,并且不应出现内存复制。 -
Einstein summation / einops
仍然是上述问题,使用 einops 将会方便很多:
rdm2[so, so] = -2 * np.einsum("jbia, kbia -> jk", T, t)rdm2[sv, sv] = 2 * np.einsum("jcia, jcib -> ab", T, t)Gamma = np.einsum("Pjb, jbia -> Pia", Y, T)尽管上述代码是 MP2 梯度相关代码,但在 MPQC、Q-Chem、PySCF 涉及 CC 计算的模块,类似的代码是常见的。
譬如 Q-Chem:
// ccman2/ccman2/cs_cc/cs_ccsd_pt.Ccontract(d, t2a_re(c|d|i|j), i_vvov_re(a|b|k|d))譬如 MPQC:
// ccsd.h, line 342tau("a,b,i,j") = t2("a,b,i,j") + t1("a,i") * t1("b,j");即使是这样直观的代码,如果配合高效的 einops,那么也能达到相当可观的效率;但 einops 并不是容易编写的库。
NumPy 也有一些难以处理的问题;在 PySCF 中,一些计算过程需要依赖于 C 实现,且 Python 下除非使用 numba 否则难以高效实现的问题,包括
- 涉及到内存复制的矩阵转置;
- 手动并行与三角矩阵乘法 (如 AO2MO 计算)。
这些问题有一些是 NumPy 本身的问题,也有 Python 语言的问题。
总体而言,在计算化学中,我们需要矩阵乘法的功能,但也对 NumPy 所支持的高维张量功能、以及其特色功能也有较大需求。
1.4. Python Array API 与现有矩阵、张量库
NumPy 的不仅对接了计算化学所需要的一些功能,其 API 接口的便利性也是至关重要的。在 10' 年代 NumPy 已经成为 Python 事实上的数值计算程序;在机器学习爆炸式发展的 15'–20' 年代,Tensorflow、MXNet、PyTorch 等库的发展与竞争过程中,从我看来,PyTorch 目前的成功很大程度上也是因为其接口与 NumPy 非常接近,易于新手使用、避免较高的学习成本、减少库与库之间的交流成本。
Python 数学库的作者们也意识到 API 接口的重要性。在 2020 年,一组社群对 Python 数学库的接口形式作讨论,基于 NumPy 与其他流行的数学库,以 Python Array API Standard 的方式,确定数学库所必须要满足的 API 接口 (在 NumPy 2.0 后,Python Array API Standard 是 NumPy API 的真子集)。
Python Array API 尽管是 Python 接口,但在设计过程中也考虑了其他语言;包括 C++、Rust 的其他语言也可以一定程度上遵循该接口的规则,作程序开发。我个人也希望我们开发的库也尽量考虑到 Python Array API。
1.4.1. Python Array API 及与其有关的数学库
目前绝大多数成功的数学库,其 API 接口都与 NumPy 接近、或本身就是受到 NumPy 影响与启发而设计的库。
| API 语言 | 数学库 | 平台 | 特色 |
|---|---|---|---|
| Python | NumPy | CPU | 1. 基于 BLAS 较为完善的线性代数功能 (linalg, fft) 2. 可以扩展为 SciPy 丰富的线性代数功能 3. 高级索引 (advanced indexing) 4. 更多的数值数学功能 (稀疏、多项式、统计) |
| Python \ C++ | PyTorch \ LibTorch | 多平台 | 1. 多平台/后端支持 (HPU/NPU/FPGA/RISC-V) 2. backward、基于计算图的 lazy evaluation |
| Python | JAX | CPU \ CUDA \ TPU | 1. 基于 JIT,对小矩阵任务有性能提升 2. backward、基于计算图的 lazy evaluation 3. 对 MPI 有一定程度支持 |
| Python | Paddle | 多平台 | 1. 支持大多数国产 GPU 2. 支持分布式训练 |
| Python | CuPy | CUDA \ ROCm | 1. 支持大部分 SciPy 的线性代数功能 2. 较为轻量级,编译与安装相对容易 3. 支持 Python 中嵌入 CUDA 代码,灵活性高 |
| Python | DASK | MPI | 1. 为多机并行、处理大型张量设计 2. 设计了专用的通讯与队列模块 (distributed) |
| C++ | XTensor | CPU | 1. lazy evaluation |
| Rust | ndarray | CPU | 1. 从语言层面解决 mutability 与 data type promotion |
| JavaScript | stdlib | CPU | |
| Go | Gonum | CPU |
但也需要指出,成功的数学库未必一定遵照 Python Array API;这点在 Rust 语言中也有表现,我们将在下一小节作补充。对于其他语言,
- Fortran、Matlab、Julia 等语言原生支持高维张量、并部分支持一些数学运算;
- Fortran、C/C++ 的许多程序直接使用高性能 BLAS;不一定使用外部封装库、或自研简易封装库;
- C++ 下 Eigen 库较为特殊:它有较强大的 lazy evaluation 支持、小矩阵计算性能;大矩阵计算性能不差。但其发展时间在 05' 年代,发展较早、难以掉头。
但总地来说,现今的数学库设计通常都可以表达张量类型、且 API 层面上会尽量接近 NumPy (或者 Python array API standard)。
1.4.2. Rust 语言下的数学库
Rust 生态中的数学库与机器学习库还是比较多样的,但并非所有库满足我们的需求。下表对此作简单列举。
| 数学库 | 目的 | 维护情况 | 张量 | 变维 | 可导 | GPU | 复数 | 线代 |
|---|---|---|---|---|---|---|---|---|
| ndarray | 高维张量 | 非积极 | ✔ | ✔ | 1 | ✔ | ✔2 | |
| faer | 高性能 | 开发 | ✔3 | ✔4 | ||||
| nalgebra | 线性代数 | 积极 | ✔ | ✔ | ||||
| dfdx | AI 后端 | 非积极 | ✔ | ✔ | ✔ | |||
| candle | AI 后端 | 开发 | ✔ | ✔ | ✔ | ✔ | ||
| burn | AI 前端 | 开发 | ✔5 | ✔ | ✔ | ✔ | ||
| sprs | 稀疏矩阵 | 开发 | ✔ |
- ndarray 预期不会实现 GPU 支持 (ndarray #1377)。
- ndarray 线性代数由外库 ndarray-linalg 提供;后者已经停止维护。但 ndarray 与 faer、nalgebra 之间的相互转换是比较容易的;因此尽管生态较为割裂,同时处理高维张量与线性代数的解决方案仍然是存在的。
- faer 的复数支持较强,但它本质上不是通用矩阵库、而是对标 OpenBLAS 的高性能计算库,因此仅对常用浮点类型作实现。库作者对 F16、BF16 有所了解,但短期不会引入 faer (faer-rs #32)。
- faer 目前支持的线性代数功能较少,但性能较高。
- burn 确实有高维张量,但这主要是为了储存机器学习所需的张量。库本身不支持 stride 功能,因此不能对张量作通用计算。
除此之外,einops 作为支撑库,也对计算化学程序有重要的潜在帮助。目前 Rust 下接近的库是 einops (服务于 tch-rs)、以及 candle_einops (服务于 candle),即这些库主要针对机器学习应用。
2. Rust 张量库 RSTSR 意义与目标
上述讨论中,我认为,目前的 Rust 数学库,对于现在的计算化学程序仍然有一些欠缺。发展一个新的数学库短期内不一定有价值,但长期来看这是必要的。
为此,我尝试启动 RSTSR 程序,并希望在这个项目上投入时间。我希望这样的程序将以辅佐化学程序开发为目的,同时一定程度兼顾现有张量库标准、以及其他科学计算可能的需求。
2.1. 张量库的细分功能
对于计算化学,我认为数学库需要承载的功能至少包括
- 高维张量的数据结构,及其基本运算 (Python array API standard);
- 基础线性代数 (矩阵分解、本征问题) 与 FFT (若支持周期性体系);
- 多线程或其他并行模式 (保证可以利用至少 30% 以上计算机浮点或带宽效率);
- 复数类型、尽可能支持任意类型 (特别是任意浮点精度类型);
上述的特点也是 NumPy 的功能 (的子集)。其中不少功能也在 Rust 库 ndarray 中有所表现,但它在线性代数上弱势、且下述重要可选功能不足。
重要的可选功能包括
- 高级线性代数 (插值、二次收敛与求解、矩阵函数极值,但未必单独成数学库);
- einops (简化张量计算代码,统一张量乘法实现,但可以用基础矩阵代数替代);
- GPU 异构 (性价比更高、计算速度更快的设备);
- 特殊 BLAS 功能 (batched GEMM 可能用于 DMRG 方法、基于 BF16 的 FP32 GEMM 可能用于 post-HF 方法);
不确定是否重要的功能包括
- MPI 异构 (依技术路径选取,可能分为 Dask 原生支持式、以及 Scalapack 非原生支持式);
MPI 是否重要,取决于 1) 程序主要并行模式采用线程还是进程,2) 程序是否着重于大规模并行;不少计算化学程序少有多进程支持,但也非常成功; - 小型矩阵乘法 (部分 DFT 运算需求);
- 对称张量运算,张量对称/反对称化 (对称性体系、CC 算法);
- 通用的稀疏矩阵数据结构与基本运算;
- 计算图与自动导数 (这是机器学习程序最重要的功能,但计算化学本身通常不需要该功能;如果我们的程序需要接入机器学习,这个功能需要考虑);
不一定重要的功能包括
- lazy evaluation (一般用上它的情况是内存瓶颈代码,但矩阵乘法为主导的问题要么不是内存瓶颈、要么可以牺牲少量代码美观性以保证效率;lazy evaluation 有一定实现难度,这会给库程序维护与开源合作带来很大麻烦)。
2.2. 张量库 RSTSR 的目标与预期的实现阶段
在张量库 RSTSR 中,我们将着重于实现高维张量数据结构、与 GPU 异构。目前已经完成的工作集中在高维张量数据结构及其基本运算:
- 高维张量数据结构;
- 大多数 Layout 操作 (不更改底层数据的张量操作);
- 基于 Layout 的张量元素迭代器 (迭代器与底层数据分离);
- Broadcasting (不同维度张量的匹配规则);
- 对计算问题,分离 backend (后端) 实现与 frontend (前端) 接口;
- 张量的四则运算 (较为高效的单线程实现);
- 张量的矩阵乘法 (正确性实现,效率需要通过后续 backend 提升);
- 张量的生成、形状改变。
这些工作是初步工作,目前还没有成型到可以应用于 REST 程序。
如果可以全职地发展 RSTSR 张量库,我认为合适的时间表是
- 2–4 周完全复现 Python array API 中所需求的大部分功能 (不包含线性代数);
- 2–4 周完成并行计算代码、BLAS/Lapack backend 与 faer backend;
- 2–3 周实现 rest_tensor 中的补充功能 (包含线性代数);
- 4–8 周基于 cudarc 实现 CUDA backend;
- 2–4 周提出基于 Scalapack 的 MPI 解决方案 (但不写成库)。
上述流程中,前两个流程是需要先进行的;后续流程顺序可以打乱。总共大约 3–5 月。
3. RSTSR 设计与已实现技术说明
Rust 语言通常将复合类型清晰地分为两部分:1) 数据结构 (struct) 或接口特征 (trait);2) 对其的实现 (impl)。一般来说,实现 (impl) 是容易被替换的;但数据结构 (struct) 与接口特征 (trait) 的改变容易导致严重的代码重构。
在上述「张量库的细分功能」一节列举的细分功能中,会对数据结构和接口特征产生深刻影响的有
- 高维张量数据结构,及其基本运算;
- GPU 异构;
- 对称张量;
- 计算图与自动导数;
- lazy evaluation。
其他细分功能相对独立,不会对程序设计的基调产生重要影响,除了 9. MPI 异构:不论是否采用原生支持路径,MPI 异构不可能直接在单独的高维张量上实现,它必然会将单个大的高维张量拆成小份;因此 MPI 异构一定是基于已有完善的高维张量数据构建而来; 12. 稀疏矩阵:它与高维张量区别太大,一般会采用异于高维张量的数据结构。
RSTSR 现阶段只考虑高维张量、以及应对未来 GPU 的程序。尽管这里称 GPU 是异构,但我们现在仅将其视为不同于 CPU 的后端。事实上,当我们将 BLAS 和 faer 也视为两种张量计算实现后端,那么 CPU 的高性能库本身也是后端,其实现与将来 GPU 的实现是一样的。因此,多后端实现也应该尽早考虑。
3.1. 放弃实现的功能:自动导数与 lazy evaluation
自动导数需要的是计算图功能。这类型功能有至少两个核心困难:
- Expression tree;
- 变量所有权。
Expression tree 的实现难度稍大。它本质上也是 lazy evaluation,可以在这个框架下实现异步计算 (CUDA 流式计算),也可以简化计算流程 (如 c += 2 * a 简化为 famdd(c, 2, a))。但它并非常见的科学计算会遇到的数据结构。其 inplace 运算的规则实现较为困难,即使是 PyTorch 早期也经常出现 inplace 运算错误。
同时,Rust 作为变量生命周期非常严格的语言,树状结构的实现确实是困难的。事实上,candle 与 burn 在实现自动导数时,直接使用了 RwLock 或者 Arc 智能指针,避免使用受生命周期影响的普通变量表示张量。
我的看法是,如果未来我们需要引入自动导数,我们需要做到下述两点:
- 另外写一个 AI 前端程序,将 RSTSR 程序作为后端,而非在 RSTSR 直接写前端;
- 寻求科技企业的合作。
自研自动导数程序而不对接产业需求未必没有意义,但很难打开受众;假设 Rust 确实可以做机器学习,那到头来科技企业主导的项目做得比我们更受用,以至于我们会浪费太多时间开发程序后被废弃。而如果目标只集中于多后端的科学计算,那么我们程序编写的自由度会大许多,程序难度降低不少;在规模性的大企业做这件事之前,我也有信心把它做好,至少不会把时间浪费掉。
3.2. 放弃实现的功能:对赋值语句的重载
这是 Rust 的特性。C++ 中,等号 = 可以被 operator= 函数重载;但 Rust 不允许这种情况发生。
这带来的结果是,至少下面两种 C++ 方便的做法,在 Rust 中是不可行的:
-
关于 lazy evaluation,如果我们关注其内存复用,在 C++ 的 Eigen 库中,一个典型的例子是
mat1.noalias() = mat2 * mat2;这样能保证
mat1的内存可以被复用,但这是通过operator=函数重载实现的。 -
类似于 MPQC 的张量缩并
tau("a,b,i,j") = t2("a,b,i,j") + t1("a,i") * t1("b,j");中,缩并运算同时需要
operator=左右的字符信息,而不能简单地通过 RHS 赋值到 LHS 完成。
3.3. RSTSR 数据结构
RSTSR 项目学习了 (或打算学习) 许多其他库的策略:
- ndarray:数据结构、生命周期管理、reduce 操作的向量化;
- candle + cudarc:GPU 后端接入到 Rust 程序;
- burn:多后端实现的外部 API;
作为基本的数据结构,RSTSR 的张量将以下述方式表达:
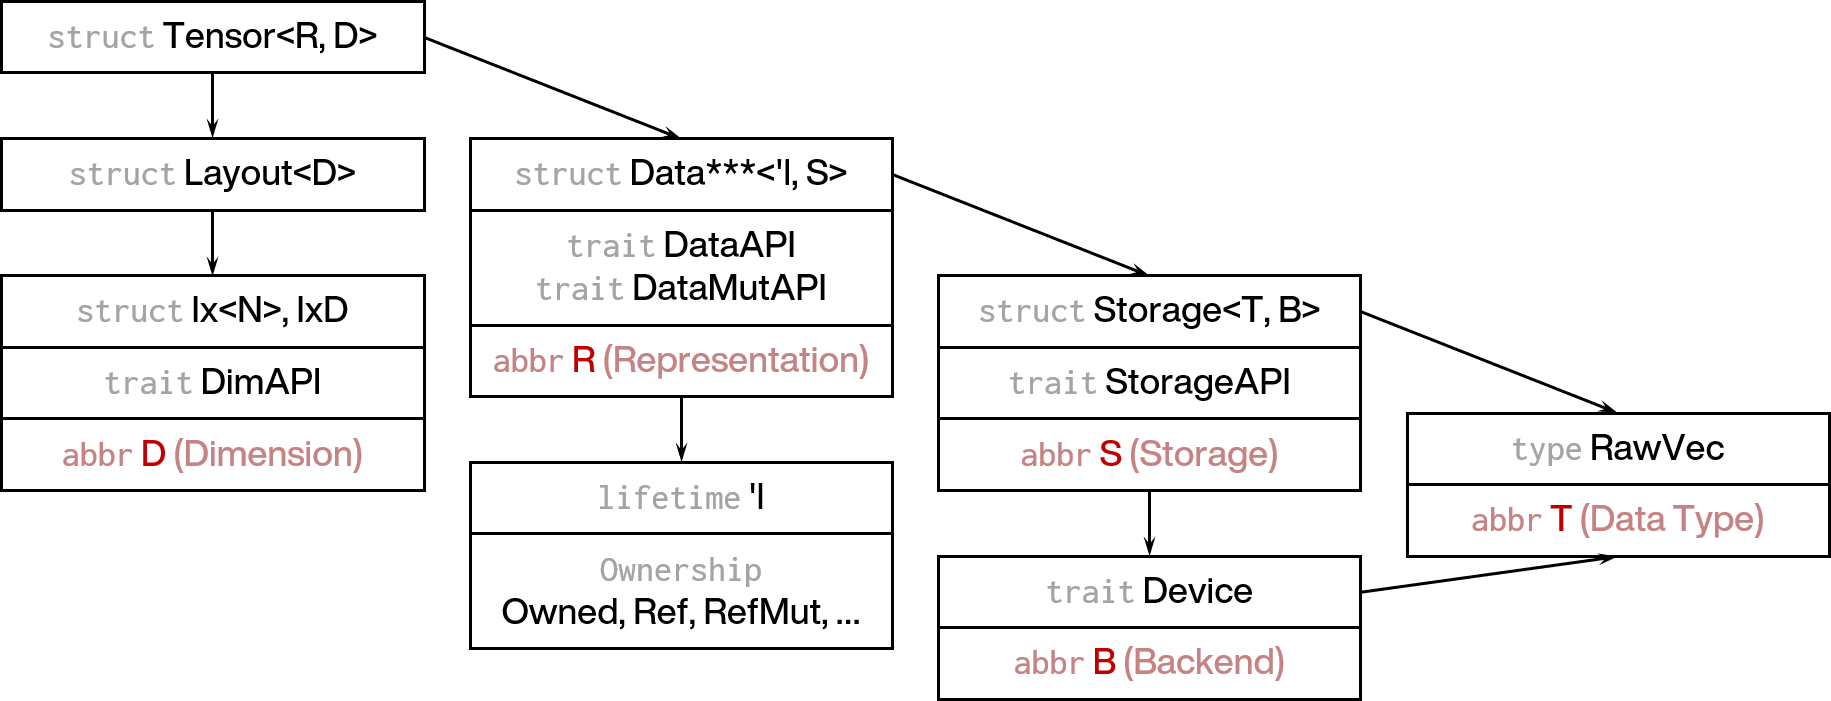
- 张量拆分为底层数据 (
DataOwned与布局Layout); - 形状 (
Layout) 拆分为维度 (shape)、跳越量 (stride)、起始地址 (offset); - 维度类型由
DimAPI规范,它可以是固定维度数组 ([usize; N]),也可以是可变维度数组 (Vec<usize>);高效计算一般倾向于使用前者。 - 底层数据拆分为后端 (
DeviceAPI)、底层数据类型 (RawVec)、生命周期与所有权; - 由于后端与底层数据有所耦合,因此其拆分策略如上图所示。
上述数据结构与 burn 和 ndarray 都不太相同:
- burn 直接定义
Tensor<B, D, T>,但它在变量所有权与生命周期上,则完全依赖于 RwLock 实现;且 burn 仅支持固定维度; - 我们的实现策略与 ndarray 更接近;但 ndarray 仅实现在 CPU 上,使用的是自定义的数据类型 (相当于手动实现了一遍
Vec<T>,有不少 unsafe 的代码)。在 RSTSR 实现时,对于 CPU backend,则用更简单的Vec<T>作为基本的数据储存格式。
3.4. 关于 view (视窗) 的实现
高维张量不可避免地会涉及到 view (视窗) 概念。我们的程序实现中,TensorBase 类型定义为
pub struct TensorBase<R, D>
where D: DimAPI,
{
    pub(crate) data: R, // Vec<T>/CudaSlice<T> (with lifetime and backend)
    pub(crate) layout: Layout<D>, // {shape, stride, offset}
}
视窗 (struct DataRef) 直接定义为
pub enum DataRef<'a, S> {
    TrueRef(&'a S),
    ManuallyDropOwned(ManuallyDrop<S>),
}
pub type TensorView<'a, T, D, B> = TensorBase<DataRef<'a, Storage<T, B>>, D>;
且我们一般只使用 TrueRef,也就意味着我们的视窗真的就是字面意义上地对 Storage<T, B> 类型的引用。ManuallyDropOwned 只用于从 &'a [T] 初始化 TensorView<T, Ix1> 的情况。
这与 ndarray 的差异较大;他们是在 ArrayBase 中储存所有底层的信息:
pub struct ArrayBase<S, D>
where S: RawData
{
    data: S, // Customized Vec<T> if OwnedRepr
    ptr: std::ptr::NonNull<S::Elem>, // offset
    dim: D,                          // shape
    strides: D,                      // stride
}
但如果这个向量是被引用的 (ViewRepr),那么 ArrayBase.data 就只有生命周期:
pub struct ViewRepr<A> { life: PhantomData<A> }
我们没有采用 ndarray 的做法。这是因为 CPU 设备之外的情况下,使用指针的目的只能是获取底层数据及其连带的后端设备信息,而不应用来作指针位置计算 (以作具体的张量计算)。这也要求被引用的数据也需要有底层数据及其连带的后端设备信息,而不能是空的生命周期。
这么做当然带来了一些麻烦。上面提及的 ManuallyDropOwned 是其一。但这在程序维护上方便很多、也直观很多。
3.5. 关于 Layout 的实现
在给定原始数据后,张量是被维度 (shape)、跳越量 (stride)、起始地址 (offset) 所定义的:
pub struct Layout<D>
where D: DimBaseAPI,
{
    pub(crate) shape: D,
    pub(crate) stride: D::Stride,
    pub(crate) offset: usize,
    size: usize,  // this may not be necessary and may be removed
}
在明确分离了数据与形状之后,很多张量的操作就可以明确地只在形状 (layout) 上做手脚,而完全不牵动底层数据 (data)。譬如,如果我们实现了 Layout<D> 的转置函数 transpose,那么张量 TensorBase<R, D> 的转置就很容易实现:
// different to actual implementation: `axes: &[I: TryInto<isize> + Copy]`
pub fn transpose<I, R, D>(tensor: TensorBase<R, D>, axes: &[isize]) -> Result<TensorBase<R, D>>
where R: DataAPI, D: DimAPI,
{
    let layout = tensor.layout().transpose(&axes)?;
    unsafe { Ok(TensorBase::new_unchecked(tensor.data, layout)) }
}
而 ndarray 中,layout 与 tensor 直接绑定,导致的结果是 permute_axes (与 transpose 等价) 函数需要直接在张量类型中实现 (source of permute_axes)。
单是 Layout 改变、而不具体地对张量数据产生变化的操作,至少有
- 取子张量,例如
a.slice([.., ..3, None, 5..8]); - 转置,例如
a.transpose([0, 2, 1]); - Broadcasting (如维度 [5, 1, 3, 1] 与 [4, 3, 2] 可以 broadcast 到 [5, 4, 3, 2] 而不产生新的张量数据);
- 对张量的迭代可以转为对 Layout 的迭代 (导出 offset 数值),使得任意 backend 的迭代容易实现。
3.6. 关于 CPU backend 张量加法的实现
作为分离张量库前端与后端的例子,我们拿加法运算作为例子,表明后端分离的大体思路,以及一些简单的性能优化策略。
首先需要达成的共识是:我们不专门处理小型矩阵或张量的计算,这在计算化学中尤为如此;因此,我们会假设张量运算的计算代价远远大于 Layout 变换的计算代价 (一般不大于 10 μs)。
3.6.1. 加法的函数签名 (signature) 与后端分离策略
这部分内容并非本库的特色;它在 ndarray 中已经有所实现。
我们可以注意到,加法有数种情况:
C = &A + &BC = A.view() + B.view()C = A + &BC = A + BC = &A + b(bas scalar)C = A + b(bas scalar)C += &BC += b(bas scalar)- ......
这里可能出现的情况有不少,但总地来说,加法运算一共分为 6 种情形:
add_tenary(&mut C, &A, &B),add_binary(&mut A, &B); let C = A,add_assign_binary(&mut C, &B), 4--6 情形是当B不是张量、而是 scalar 的情况;我们暂时不讨论这类情况。
这里会注意到,
C = &A + &B与C = A.view() + B.view()的实现应为add_tenary(&mut C, &A, &B);C = A + &B与C = A + B的实现应为add_binary(&mut A, &B); let C = A;- 在允许的情况下,它将 inplace 执行
A = &A + &B,随后赋值C = A; - 但如果维度不允许 (
B.shape()not broadcastable toA.shape()),那么执行add_tenary(&mut C, &A, &B);
- 在允许的情况下,它将 inplace 执行
C += &B的实现为add_assign_binary(&mut C, &B)。- 需要指出,
add_binary(&mut C, &B)与add_assign_binary(&mut C, &B)的任务非常相近,但前者是C = &C + &B,而后者是C += &B,+(add) 与+=(add-assign) 不是同样的运算。但相同地是,这两者都是二元运算,有相同的函数类型。
- 需要指出,
最终,我们将三元运算、二元运算总结为
pub fn op_mutc_refa_refb_func(
    c: &mut TensorBase<RC, DC>,
    a: &TensorBase<RA, DA>,
    b: &TensorBase<RB, DB>,
    f: F,
) -> Result<()> {...}

pub fn op_muta_refb_func(
    a: &mut TensorBase<RA, DA>,
    b: &TensorBase<RB, DB>,
    f: F,
) -> Result<()> {...}
并派生下述赋值二元运算
pub fn op_refa_refb_func(
    a: &TensorBase<RA, DA>,
    b: &TensorBase<RB, DB>,
    f: F,
) -> Result<Tensor<TC, <DA as DimMaxAPI<DB>>::Max, B>> {...}
至此,张量层面的函数抽象已经完成。后面的任务是
- 在用户使用层面,向上实现
Add,AddAssigntraits; - 针对 backends,向下实现具体张量加法的运算。
3.6.2. 加法后端的函数签名
张量的加和,其具体实现需要最低限度的数据是
- 张量的原始数据 (CPU 下是
Vec<T>或&[T]); - 张量的形状信息 (
Layout<D>)
在 storage/operators.rs 文件中,针对下述情形,我们定义了运算接口
-
add_tenary(&mut C, &A, &B)pub trait DeviceAddAPI<TA, TB, TC, D>whereTA: core::ops::Add<TB, Output = TC>,D: DimAPI,Self: DeviceAPI<TA> + DeviceAPI<TB> + DeviceAPI<TC>,{fn op_mutc_refa_refb_add(&self,c: &mut Storage<TC, Self>,lc: &Layout<D>,a: &Storage<TA, Self>,la: &Layout<D>,b: &Storage<TB, Self>,lb: &Layout<D>,) -> Result<()>;} -
add_assign_binary(&mut C, &B)pub trait DeviceAddAssignAPI<TA, TB, D>whereTA: core::ops::AddAssign<TB>,D: DimAPI,Self: DeviceAPI<TA> + DeviceAPI<TB>,{fn op_muta_refb_add_assign(&self,a: &mut Storage<TA, Self>,la: &Layout<D>,b: &Storage<TB, Self>,lb: &Layout<D>,) -> Result<()>;} -
add_binary(&mut A, &B); let C = A:该情形现在的实现是偷懒了;现在其实做在DeviceOp_MutA_RefB_API里,没有明确地作后端分离。
至此,前后端分离已经完成。对于 CPU 就将上述 traits 应用到 DeviceCPU 上,对 CUDA 就将上述 traits 应用到 DeviceCUDA 上。CPU 已经实现,但 CUDA还任重道远。
3.6.3. CPU 下的张量加法实现
现在我们对上面的 trait DeviceAddAPI (或函数 op_mutc_refa_refb_add) 的 CPU 实现作说明。实现在 cpu_backend/operators.rs:
impl<...> DeviceOp_MutC_RefA_RefB_API<...> for CpuDevice
where ..., F: FnMut(&mut TC, &TA, &TB),
{
    fn op_mutc_refa_refb_func(&self,
        c: &mut Storage<TC, CpuDevice>, lc: &Layout<D>,
        a:    & Storage<TA, CpuDevice>, la: &Layout<D>,
        b:    & Storage<TB, CpuDevice>, lb: &Layout<D>,
        mut f: F,  // such as `|c, a, b| *c = a.clone() +  b.clone()`
    ) -> Result<()> {
        // re-align layouts
        let layouts_full = translate_to_col_major(&[lc, la, lb])?;
        let layouts_full_ref = layouts_full.iter().collect_vec();
        let (layouts_contig, size_contig) =
            translate_to_col_major_with_contig(&layouts_full_ref);
        // contiguous if possible, otherwise use iterator of layout
        if size_contig >= CONTIG_SWITCH { // CONTIG_SWITCH ~= 16
            let iter_c = IterLayoutColMajor::new(&layouts_contig[0])?;
            let iter_a = IterLayoutColMajor::new(&layouts_contig[1])?;
            let iter_b = IterLayoutColMajor::new(&layouts_contig[2])?;
            for (idx_c, idx_a, idx_b) in izip!(iter_c, iter_a, iter_b) {
                // compiler should optimize following for loop with SIMD
                for i in 0..size_contig {
                    f(&mut c.rawvec[idx_c + i],
                         & a.rawvec[idx_a + i],
                         & b.rawvec[idx_b + i]
                    );
                }
            }
        } else { // not contiguous after transpose in any cases
            let iter_c = IterLayoutColMajor::new(&layouts_full[0])?;
            let iter_a = IterLayoutColMajor::new(&layouts_full[1])?;
            let iter_b = IterLayoutColMajor::new(&layouts_full[2])?;
            for (idx_c, idx_a, idx_b) in izip!(iter_c, iter_a, iter_b) {
                f(&mut c.rawvec[idx_c],
                     & a.rawvec[idx_a],
                     & b.rawvec[idx_b]
                );
            }
        }
        return Ok(());
    }
}
这是通用的三元运算实现;通过该函数实现加法是非常容易的:
op_mutc_refa_refb_func(
    c, lc, a, la, b, lb,
    |c, a, b| *c = a.clone() +  b.clone()
)
简单地分析加法的实现原理。其核心的部分是,如何重排三个向量的 layouts。我们首先假设三个向量的 layout lc, la, lb 具有相同的 shape。
Elementwise 的张量运算核心的问题,是内存对齐。相对于更复杂的 Matrix Multiplication 问题,在 CPU 下,Elementwise 运算是很简单的,是不需要复杂技巧也容易达到较高性能的问题。
设想现在有三类 layouts (假设张量 A, B, C 都是相同的 layout):
-
F-contiguous:这是最方便的情况;内存从头扫到尾就行。
-
C-contiguous:由于我们的程序只实现了 F-contiguous 的 Iterator (但这一般已经够用了),我们需要将其转置到 F-contiguous:
shape : [ 100, 200, 300] -> [300, 200, 100]stride : [60000, 300, 1] -> [ 1, 300, 60000]这样,所有 个数的内存就连续地对齐了,从头扫到尾即可。
-
Arbitary strided with at least one dimension contiguous:这是比较特殊的情况,计算问题可以连续地处理,但既不是 C-contiguous、也不是 F-contiguous。那么我们就将张量依 stride 的大小从小到大作转置:
shape : [ 100, 200, 300] -> [200, 300, 100]stride : [80000, 1, 200] -> [ 1, 200, 80000]将 stride 从小到大排序后,还遇到另一个问题: 个数并非是连续的:每 个数是连续的,但后面要跳过 20000 个数据,才到下一组有效数据。在这种情况下,如果直接用迭代器,那么编译器不会被提示可以 vectorize (SIMD) 优化运算。所以,我们需要想办法告诉程序,其实这个张量有 60000 个连续数,你尽量对连续的数作连续计算,不连续的地方再用迭代器给的指针位置跳过去。
最后指出,如果三个张量的维度不匹配,那么加法运算就无法 vectorize 实现,而必须通过比较低效的迭代器计算。这里的低效并非指迭代器不好,而是迭代器无法提示编译器在 -O3 优化级别进行 vectorize。比如要将一个 C-contiguous 的矩阵加另一个 F-contiguous 矩阵,这本身就对内存连续性很不友好。即使如此,其实还是有比单纯使用迭代器更好的做法 (就算不能对连续的内存作 vectorize,也还有机会充分利用 L2 缓存),但这种实现复杂程度就太高了,毕竟我们可能还要处理三维张量。
当然,现在的实现在单线程下,还是比较快的;但该计算问题还可以在多线程下完成。我认为,我们可以在主程序 (rstsr-core) 中实现简单的、正确的张量加法,而在另一个库 (譬如 rstsr-rayon) 中新建一个并行后端 (DeviceCPURayon),来作并行 (或高性能) 张量加法。这对矩阵乘法也是同样的道理。除此之外,上面的分析对高效地实现多线程张量加法或许也是有帮助的。
3.7. 矩阵乘法符号 % 的提议
我提议在 RSTSR 中,矩阵乘法 (matmul) 占用 % 符号。该符号的实现已经在 tensor/matmul.rs 中完成。即下面的表达式是矩阵乘法:
let c = &a % &b;
let c = a % b;  // in this way, `a` and `b` are consumed
它与 Python 下的语句将有类似的功能
c = a @ b # c = np.matmul(a, b)
% 符号是取余符号 (trait Rem)。
参考 Python 在引入 @ 符号作为矩阵乘法的 PEP 465,我在 RSTSR 库中引入 % 符号时有以下考量:
- 用二元运算符替代矩阵乘法,其对代码阅读的便利是相当重要的;这在 PEP 465 有详细说明;
- Rust 不能使用
@符号的原因,是因为它已经是 pattern binding 二元运算符了;因此在 Rust 语言中,横竖都不可能与 Python 一样用@作矩阵乘法; - Rust 中符号
%的 运算优先级 与*,/即乘除同级;而在 Python 中,@与*,/,//,%的 运算优先级 一致; %符号尽管在整数取余运算中很常见,但该符号几乎不可能用在矩阵运算上;- 不考虑平行与纸面的镜面,
%符号与 号都有 对称性 ()。