RSTSR 第二次报告
RSTSR 第二次报告:对电子结构程序的理解与需求:NumPy+Rust 视角
1. 前言
电子结构程序的程序开发是为了解决或发现化学、物质结构的科学问题;但其技术挑战经常与化学本身无关。电子结构程序需要同时兼顾 1) 开发效率与降低沟通成本 2) 程序效率与资源控制;这些也是其他学科的科学计算、甚至一般程序开发任务所需要解决的问题。
Rust 语言在部分计算机或其应用的领域中,有比较好的使用反响。但对于科学计算,Rust 鲜有出彩的工作;对于 Rust 是否适合科学计算,相信现在也没有可以达成统一共识的认识。
先前的 showcase_rust_riccsd 工作,相信可以表明,对于以 MP、CC 为代表的电子结构所关心的问题,在合适的工具下,是可能达到比较好的开发效率和程序效率的平衡。为了表明这种可能性,我发展了 RSTSR 作为张量计算的程序工具。受制于眼界、能力、精力,这个工具未必是理想的;但我希望能借此工具,展示我对 Rust 科学计算程序的理解和期望,为满足电子结构的张量工具的开发提供一些思路。
本文档希望用简问简答的方式,展示我对电子结构程序开发和其所关心的程序问题的理解、以及对 Rust 语言的理解。本文档的后半部分会介绍 RSTSR 程序的开发思路。
一个好的程序工具,应该要能让用户一定程度地脱离繁琐的技术细节,而专注于用户自己的目标;这也是发展数学库工具的初衷。RSTSR 强烈地受 NumPy 的影响。我们有必要表明 NumPy 或者类似的数学库工具,是如何具体地在电子结构中使用的,它们的优劣在哪里,以及我们改进这些问题的思路。
本文档假设不考虑 GPU 异构或 MPI 规模并行。一些结论可能不适合这两类情形。
该文档由原始的 typst 报告,经由 AI 转录到 mdx 格式。该转录过程由 Deepseek-v4-flash 完成。
该文档是早期文档,并不反映当前 RSTSR 设计架构与使用方法。
该文档有比较激进的观点。这些观点不反映其他 REST 程序开发团队的看法。
2. 电子结构问题
2.1. 作为科学计算问题,电子结构的特色是什么?
首先,我需要表明我对电子结构的理解并不完整。我没有写过一次 CISD、Full-CI (MCSCF)、DMRG、PBC,对这些分支领域的科学计算挑战并不了解。
这里只讨论程序实现问题,不讨论方法开发。
集中在 MP2、CC、DFT 等问题而言,电子结构程序
- 主要由矩阵运算或高维度张量 (一般不超过 4-D、鲜有超过 6-D) 的运算与缩并问题构成;
- 有部分问题涉及到本征值求解或矩阵分解;
- 有少量问题涉及到非线性方程求解 (矩阵方程的迭代求解)。
分别对应上述 3 个问题,我的一些看法是
- 任意维度张量运算与缩并可以划归为两类问题:broadcasted 矩阵乘法、broadcasted elementwise 运算。对此后面会详细说明,但这里我们只要知道,这两类问题都是比较标准的问题,可以用简单的程序与 BLAS 解决。
- 本征值问题与矩阵分解是标准问题,可以用 Lapack 解决。
- 这不是标准问题,需要化学家根据自己的需求设计算法。当然,有一些矩阵方程的求解在 Matlab 或 SciPy 中有解决方案;但其效率未必令我们满意。
因此,上述 3 个问题中,化学家有可能真正发挥其价值的是第 3 类问题;剩下的是标准问题,完全可以不由化学家参与、而由程序工程师实现。化学家在处理第 3 类问题时也并非是专业的,很可能需要全盘托付给数值数学家完成。
2.2. 化学家为什么要写电子结构程序?
上一个回答否定了化学家在写电子结构程序上的大部分价值。拿 CCSD 来说,化学家除了 DIIS 迭代之外,似乎就没有什么用处了;毕竟剩下的问题只要对着公式把程序写出来就行。如果发展 DIIS 的是数值数学家,那化学家就不用做任何事了。
但化学家仍然会写电子结构程序;这出于以下的原因:
- 没有经费、政策支持,去聘请科学计算程序员。我可能会认为,因为我们无法向社会和公众表明,我们工作有更重要的价值 (这也可能是事实),钱和资源不可能理所应当地向我们倾斜。这是没有办法的事情。
- 方法开发。化学家负责对现有方法作改进。这种改进通常是精度方面的,它有时需要引入化学直觉,也有时是一种数学结构。新方法有可能会需要新的程序工具,Davidson 对角化相信就是这么产生的;因此理想情况下,化学家同时也需要是工程师和数学家。也有一些人会对效率方面作改进 (我认为 Furche 组的 Eshuis 改进 RPA 算法是一个典型),但这类工作更像是数学家完成的,而不真的需要化学的参与。
但如果是更高效率地实现、或在新的程序中实现已有的电子结构方法、或编写已有电子结构方法的梯度性质,那么这些与化学就无关了。
我也听到过不止一人提到,跟程序工程师合作时,会强烈地感受到工程师不懂电子结构 (而产生一定程度的负面体验)。我因为没有与工程师合作过,也许我的下述理解是错的:造成这种交流障碍的可能因素在我看来是
- 或者程序工程师能力有限,无法正确理解数值问题 (与工程师不理解化学无关);
- 或者化学家没有成功将电子结构问题转化为数值问题 (因而问题出在化学家);
当然,如果一个人同时是化学家与工程师,那么这种交流障碍就不存在了。
2.3. REST 程序早期发展是否需要化学家?
在我看来,不需要。早期的程序的主要目的是将已有的算法实现 (从其他语言或工具链迁移到 REST 中),这不是化学。但能理解化学语言的工程师总是好的。
3. NumPy
3.1. 为什么你会推荐化学家使用 NumPy?它有什么优势?
这是一个主观性问题。每个人对此都应该对化学家适合用什么样的程序工具,有自己的看法。
化学家对程序设计的需求一般都应该落足于方法开发。
我推荐 NumPy 的主要原因如下:
- 脚本语言 Python。脚本语言通常有可交互的运行模式 (bash 有 shell、python 有 jupyter 等等),这是编译语言没有 (至少不方便) 的优势。
但这无法解释为何不使用 Pytorch、Matlab、Mathematica、JavaScript 或 Julia。 - 任意维度张量支持与 Basic Slicing。Basic slicing 是非复制地给出子矩阵/张量的一种手段。这种模式应该是从 Fortran 开始的,不是 NumPy 独有的特色。
但这无法解释为何不使用 Pytorch、Matlab、Mathematica、JavaScript 或 Julia。 - Einsum 的支持。这对 post-HF 方法的 prototype 实现有巨大的帮助。
但这无法解释为何不使用 Pytorch、Matlab、Mathematica、JavaScript 或 Julia。 - 快速的矩阵乘法计算。NumPy 在矩阵乘法上外接高效率的 BLAS 函数,因此,如果计算瓶颈都在矩阵乘法上,NumPy 一般不会太慢。
但这无法解释为何不使用 Pytorch、Matlab、Mathematica、JavaScript 或 Julia。 - 比较完整的线性代数支持。结合 SciPy,包括矩阵线性代数、本征值求解、FFT、ODE、极值问题等,NumPy 都有解决方案。
总算有 JavaScript 的 stdlib 不支持的 ODE 和极值问题,出局了。
上述 5 个因素中,前 3 个因素是决定性因素,缺一不可。但同时,您会发现,没有一条推荐理由,是 NumPy 独有的。所以完全可以说,推荐 NumPy 绝对是夹带私货。
NumPy 相对于其他工具而言,真正有额外优势的地方,在于
- Python 作为全能型语言。这是 Matlab、Mathematica 无法做到的,是 Julia 不擅长的。JavaScript 更适合前端。
- Python 生态。较大的生态,意味着如果你遇到任何问题,别人也可能遇到过并有公开的解决方案。PyPI 与 Conda 也对 Python 生态有重要的帮助。
- 安装的便利性与较小的运行时。这一点是相对于 Pytorch 而言的。运行时是 runtime,这里是想说 NumPy 作为 Python 库的二进制文件大小比较小、且除了 BLAS 之外就没有额外的依赖。
这些额外的优势并不是决定性的。而且,NumPy 还有缺点;一些缺点是致命的。
3.2. NumPy 有哪些缺点?
从我的使用体验出发,
-
没有自动微分。这不是电子结构程序最关心的问题,但确实是现在需求最大的特性之一。
-
没有异构支持。仅使用 NumPy 是不能在 GPU 上跑的。GPU 确实是未来科学计算的重要方向之一。
-
Python 循环慢。这个众所周知。对于许多标准的矩阵运算问题,确实我们未必需要 Python 的 for 循环;但如果遇到像下述的三角矩阵赋值问题 (可能用于 张量对称化):
for i in range(nocc):for j in range(nocc):for a in range(nvir):for b in range(a):t2[j, i, b, a] = t2[i, j, a, b]这类型运算没有合适的 NumPy 函数,会产生比较严重的计算效率问题。它尽管也有解决方案 (Numba jit),但总是不太方便的。
-
Python 迭代器难以线程并行。但 Python 的并行只对进程级别 (multiprocessing) 比较适合,而不适合线程级别。上面也是一个例子:上述 计算是可以对 指标作二重循环并行的。用比较标准的 Python 并行库,效果一塌糊涂。
-
Numba JIT 编程不是原生的 Python。上面两点都可以用 Numba 解决。Numba 也不是不行,但 JIT 本身也是时间、Numba 语法也不完全是 Python;预编译 JIT 也不是不行,但这与使用编译语言 (比如 C 的) FFI 又有什么区别?JIT 编程并非没有门槛:如果没有写清楚输入、输出类型,没有正确地开启 parallel,Numba 的加速效果也不好。
-
非连续矩阵的计算非常慢且不并行。一个典型的问题是闭壳层 RI-MP2 的能量求和问题。简化到具体的表达式上,是当矩阵 与 同时是 c-contiguous 或 f-contiguous 时, 或 的运算慢得离谱。
类似的问题还会出现在 SciPy 的调用上。SciPy 通常对 f-contiguous 矩阵比较友好;如果输入矩阵是 c-contiguous,它有时会先作非常低效率的矩阵转置。 -
连续向量的计算不并行。NumPy 其实是对连续向量的运算有优化的 (SIMD vectorization),但这主要是 10 年前的工作。10 年前的个人电脑,单线程的运算一般能吃足内存带宽;但现在的时代发生了变化,一部分问题单个线程已经赶不上内存带宽速度了。可以认为,只要不是矩阵乘法或本征值等问题,NumPy 有一定的效率提升空间。
-
一部分函数名称比较糟糕。例如
np.ix_;这可能是历史因素。 -
内存控制存在难度。这与 Python 的变量生命周期有关。Rust 可以规避该问题。
上述的部分问题,也是 Matlab 和 Mathematica 所遇到的问题。Julia 语言可以兼顾脚本语言和编译语言两者的优势,从这个角度来说确实是更适合科学计算的工具;但其语言本身的发展趋势和专业程度多少令我担忧。
3.3. 我们是 Rust 程序,为什么要提 Python 和 NumPy?
我们并不是要说 NumPy 多好或者多差。但我们是要写 Rust 程序的,需要利用一些数学库。因此我们对数学库一般具有哪些功能,需要有一个大概认识。
从科学计算的角度,NumPy 很可能并非是最好的选择。但选择以 NumPy 作为基点讨论数学库,有其原因:
- 我比较习惯用 NumPy,以及现在在开源社区中最流行的计算化学程序是 PySCF (通过 Github Star 数量来看)。这当然有个人好恶的因素在里面。
- NumPy 所基于的 Python 语言,并非为科学计算而专门设计。这点上 C++/Rust 也是同理;与之相对的是 Julia 与 Fortran。这使得很多问题必须通过函数 (或对运算符的重载) 实现、而非通过语言语法实现 (比如 transpose, slicing, matmul, vector solve, inversion)。
4. 快速开发电子结构程序的策略
4.1. 是否有快速开发电子结构程序的策略?为何这个策略没有 Rust?
如前所述,之所以我推荐 NumPy,决定性因素是
- 脚本语言,
- 任意维度的矩阵或张量支持,
- Einsum 支持。
当然 NumPy 不是唯一适合这三点的框架;但 Rust 由于不是脚本语言 (REPL 语言),我会认为该语言不适合快速开发。
Rust 并非没有 REPL 框架 (evcxr 框架),但我用下来感觉还是编译比较慢。
4.2. 是否有快速开发高效电子结构程序的策略?
这个问题加了"高效"两字,那么上面的答案就没有用了。
我自己曾经在 RI-MP2 静态极化率、RI-RHF 一阶梯度实现上,试用过的开发策略是 0. 将问题整理为数学公式,尽可能避免任何化学的描述;
- 在 NumPy 中用 Einstein 求和实现一遍;
- 这并不是说只能用 Einstein 实现,只是对 MP/CC 的任务而言,Einstein 有绝对的方便;但也有其他具体的问题适合用其他的方法实现。这里是想说,用任何你觉得方便的程序框架把你的化学问题翻译成程序,并且正确地执行。你需要考虑用什么算法、怎么优化算法,但正确性是第一位的,而且你现在不需要考虑程序实际效率。
- 在 NumPy 中将所有 Einstein 求和拆分为 (按照优先级)
- 矩阵乘法 (matmul, matrix multiplication)
- 向量运算 (elementwise)
- 求和等操作 (reduction)
- 循环展开 (for loop) 最终得到一个完全没有 einsum 的 Python 程序。
- 在 Rust/C 等编译语言中,将上述逻辑一一地翻译下来。
上述过程除了第 0、1 步,其他都是比较死板的。往坏处说,AI 辅助编程其实是有可能将 2、3 步替代掉。但为了计算性能,第 2、3 步的程序也很重要。
从我的经验来看,当第 1 步成功完成后,RI-CCSD 或 RI-MP2 静态极化率级别问题的第 2 步大概需要 0.5–5 天时间,第 3 步大约需要 1–10 天时间;具体的时间取决于工作状态、工作环境和精神集中程度,而无关乎当时的创造性强度。这件事最困难的部分一般是第 1 步,即在我们所习惯的数学库框架下,化学问题能否被正确地写成程序并执行。当然,这随着问题的不同而不同。
5. 数学库与电子结构之间的关系
5.1. 为何浪费时间要发展数学库?我们的目的不是解决化学问题吗?
我会反过来问,为什么我们要用 Rust?放弃好用的脚本语言的目的是什么?这真的就能解决化学问题了吗?
若对这个问题拒绝回答,这份文档后面所有的内容,对读者就没有任何意义。一些看似回答了该问题,但实则拒绝回答的情况包括:
- 我们的程序已经决定以 Rust 作为特色了。
- C++ 是编程界的只狼,Rust 是编程界的原神。Rust 乃抽象之典。
我估计大约 50% 左右的计算化学软件,会发展自己的数学库,或者绑定外部的数学库;一些软件可能还会发展两套,从而导致代码阅读和沟通有困难:
- Q-Chem 内部有发展多套数学库,包括 libblas, libmathtools, libtensor。
- PySCF 主要使用外部数学库 NumPy 与 SciPy,同时使用 TBLIS;但在处理一些算子时有自己的程序,一般在
np_helper.c中定义。 - Psi4 自研有数学库 libmints/matrix,只看 Psi4 的 occ 部分代码的话,这些库主要用途是 BLAS 封装;
- MPQC (作为已经停止维护的计算化学程序) 与其他课题组合作 MADNESS (现在仍然在积极维护)。
我不敢说发展数学库的原因就不言自明了,但发展数学库确实是很多电子结构开发者的选择。
但也有很多人,特别是更偏高性能计算的工程师,估计选择不使用既有的数学库。他们可能需要更为灵活的程序编写模式,最多使用 BLAS 或 FFT 等底层程序,而不会大量使用上层接口。
数学库的意义是比较微妙的。在我看来其目的是:平衡开发效率与程序效率。
- 为最高的开发效率,一般应该使用脚本语言 Python, Matlab, Julia;
- 为最高的程序效率,一般应该直接调用底层 BLAS 和手写部分函数。
因此,对数学库的一般要求是
- 实现重要的算子,以满足一般数值计算的需求;
- 对于被实现的算子,其实现效率应该接近理想极限;
- 代码应该足够简单直观,且不容易被用户错误地调用。
即使数学库的意义比较微妙,我仍然认为有必要在计算化学程序中使用数学库。这件事上,不同的人有不同的判断;因此这个发言可以看作是我的理念主张,并未必是理性的。先前 RI-MP2 静态极化率的实现工作中,我的工作流是 NumPy 先打一遍草稿,随后 C 语言实现;前后历时大约一周。C 语言部分主要是通过调用 BLAS 实现的。但调用 BLAS 很容易出错,这是指在矩阵维度与 leading dimension 的编写上很容易搞错而且程序不会报错;这样的代码也不直观。因此,为了更快地写出高效正确的代码,我有动力发展数学库。
5.2. 实现数学库太费劲了;能不能针对电子结构设计特色的数学库?
我对这个问题持有否定立场。
电子结构所对数学库的需求,已经涵盖了大多数数学库 (以 NumPy 为代表) 的功能了。能满足电子结构需求的数学库,一般也能满足其他学科的用途。
后文会具体讨论电子结构可能对数学库功能的需求。
对于数学库开发困难的问题,我认为,用不擅长或不方便的框架开发程序也是时间成本,开发一个框架也是时间成本。我很难评估到底哪一个更花时间,但后者确实会给人一种什么事情都没干,也不清楚到底在哪一个具体的步骤上没有把电子结构方法实现出来的景象。事实上,除了我自己之外的其他开发者、以及非开发者的同学,也无法认同开发一个数学库,因为这看起来很困难;而且在现在 PyTorch 很强大的情况下,这么做的边际收益似乎越来越低。只有解决了 NumPy 本身的不足、赞同 Rust 语言作为新发展的编译语言的优势、开发的库在使用便利和性能上都尚且满意、功能相对完善的情况下,新开发一个数学库才可能有正向收益;而即使如此还是无法与 PyTorch 的功能和生态正面对抗。
5.3. 为什么不考虑使用 PyTorch 的 Rust binding?
PyTorch 几乎是目前最好的数学库框架,即使不看它更强大的自动导数功能。我也非常崇敬 PyTorch 的 Rust binding crate tch-rs 的作者;这绝对不是一个简单的 binding,它本身就是一个很不错的 Rust 数学库的解决方案。
我认为下述因素不见得是决定性的,但综合起来我倾向于不使用 PyTorch 的 Rust binding crate tch-rs:
- PyTorch 的运行时太大,用户链接容易出现问题 (CPU only 的情况会好一些),在一部分设备上运行有可能存在困难;纯 Rust 的框架可以减少这些依赖,至少可以减少到只需要 BLAS (如果以后支持 GPU 可以再有 CUDA)。将 PyTorch 视作一种可选的后端比较好,而不适合绑定在这一个框架上。
- crate
tch-rs作为 libtorch 的 binding 与 Rust 原生接口,已经比较强大了;但这仍然是一个外来库,不能完全指望我们为了电子结构的目的而顺利地向其增加功能。 - 从
tch-rs的张量取出或放入数据,现在似乎只能通过复制的方式。Rust 对数据的标准容器要么是Vec<T>要么是&[T],产生或取出数据没有任何开销;但tch-rs把数据完全交给 C++ 的部分了,而 Rust 部分不再对数据有控制权,从而如果你要对数据作tch-rs以外的操作时,会产生很大的开销。 tch-rs似乎不处于积极维护状态,但一直在更新 PyTorch 版本和依赖库以保持可用 (也可能是该库已经处于完成状态,不需要更新)。tch-rs开发者 (Laurent Mazare) 的重心现在是 candle 库,但 candle 似乎与电子结构的距离更远了。- 接着上面的两个原因。我认为之所以作者后来开发 candle,是因为 PyTorch 的算子在 LLM 时代并不一定是最新的;但在 PyTorch 后端里写新的算子,如果不是 C++ 就不太方便;为了在不同于 PyTorch 的框架下跟上 LLM 的发展,需要一个新的机器学习框架。当然,这不是我们要关心的问题,但意味着使用
tch-rs会牺牲可观的灵活性。 tch-rs框架上不是不能,但现在对复浮点数的支持基本为零。
5.4. 为什么不考虑用其他 Rust 下的数学库?
其他 Rust 下的数学库也并非不能用,但我希望能做得更好。同时参考后文 RSTSR 特性。
但我还想说,我在开始接触 Rust 时,抱的心态是,别人十年前就已经写了数学库了,我们不如就用他们的。我很长一段时间都是这个态度,直到我无法方便地使用 ndarray 框架在 RHF 一阶梯度问题上达到我满意的程序运行效率;而 RHF 一阶梯度问题最好需要三维张量支持和比较接近 basic slicing 的索引支持,rest_tensors 也不是很适合胜任。
我希望我希望开发 Rust 下数学库的心态,不是 Not Invented Here 效应。因此,我想借该文档,充分表明我对数学库和电子结构之间关联的理解,确定我们到底要什么,我为什么不满足于已有的工具。
5.5. 电子结构程序需要用到数学库哪些功能?
我们反过来回答该问题。数学库一般有哪些功能?其中哪些会被电子结构程序用到?
Python 语言下的数学库在 2016–2017 年机器学习流行而爆发后,自 2020 年开始社区形成了 Python array API standard。这个标准尽管不是强制性的,但 NumPy 2.0 版本启用了该规范;且该规范有助于我们了解一般用户和开发者对数学库的期望和基本要求。
Python array API standard 的主要内容在 API specification 中。其中主要的部分是
-
Array object:任意维度稠密张量 (包括 0-D 标量) 的定义、以及其加减乘除等基本运算。
- 在 CCSD 计算需要使用 二次激发张量,各种能量和梯度计算中需要 等 3c-2e ERI 或其 Cholesky 分解,MP2 梯度计算经常需要储存 的其中三个维度。一般来说,计算化学对于 3-D 张量是刚性需求、4-D 张量也经常需要用到。同时,梯度中经常有 这样的三维张量 (其中 代表 三个分量);尽管它确实可以储存为三个 2-D 矩阵的 Vector,但直接储存为 3-D 张量一般来说更方便。
-
Broadcasting:张量的广播计算。它的规则很复杂,但实际应用是两种情况:
-
直和或直积。在 MP2 或 CCSD 能量计算时,会遇到需要一个矩阵 (仅关于指标 的 2-D 矩阵;指标 一般用在外循环中),它需要由下式计算:
d_ab = e_occ[i] + e_occ[j] - e_virt[:, None] - e_virt[None, :]这是一个标准的直和计算。这里同时用到 broadcasting 与新增一个维度 (unsqueeze / newaxis) 的 basic indexing 技巧。
-
不同维度矩阵运算。这是 broadcasting 本来的用途,化学里用到得不多;但对于能用到的情形,broadcasting 会非常方便。譬如处理梯度矩阵与密度矩阵的乘法:
令变量
slc是 原子上基函数的集合 (我们现在讨论基于原子轨道的程序),de[atom, :] -= (deriv_h[:, :, slc] * rdm1[:, slc]).sum(axis=(-1, -2))上述计算利用到了 3-D 与 2-D 矩阵的数乘,是 broadcasting 乘法。
-
-
Creation Functions:张量生成函数。空张量、零张量、单位矩阵。
-
Data Types:它不是具体的函数,而是要求张量库至少能处理 8–64 位整数与无符号整数、32–64 位浮点数与复浮点数、以及布尔类型。
-
Element-wise Functions:运算函数。这包括 abs, sin, log, greater, floor, isnan 等常用函数。其实不少函数化学上是用不到的,但还是需要应对 Laplace-Transform 等方法对这些函数的需求。判断电子占据数经常需要用大小判断。
-
Indexing:任意维度索引,一般是指 NumPy 的 basic indexing,但 Python array API standard 还要求布尔张量索引。计算化学对 basic indexing 与布尔张量索引 (或与其类似的指标列表索引) 都有需求:
-
broadcasting 的两个代码案例中, 直和计算需要用到 newaxis 的索引 (利用索引增加一个维度); 的计算则是标准的取出部分连续原子轨道的索引。
-
一些特殊的冻结轨道、或 CAS、或 MOM 的轨道选取,是通过一个指标列表索引实现的。假设我们希望得到体系的 [1, 2, 3, 5, 6] 个轨道,
frz_orbs = [1, 2, 3, 5, 6]frz_coeff = mo_coeff[:, frz_orbs]
-
-
Linear Algebra Functions:矩阵乘法、矩阵转置、张量乘法、向量内积。我们一般用前两者,且前两者的重要性已经不言而喻了;张量乘法由 tensordot 实现,也是经常用的功能,只是在牺牲代码可读性或简便性的前提下,它可以用矩阵乘法替代。
-
Manipulation Functions:常用函数有更改形状 reshape、张量转置 permute_dims (transpose)、堆叠或拼接矩阵 stack, concat。reshape 是非常常用且重要的函数。
-
Searching Functions:argmax/argmin, nonzero, where。这些函数我们用得不多。
-
Set Functions:将张量转换为集合 (set,程序语境下的)。我们不用这些函数。
-
Sorting Functions:排序函数。电子结构用得不多,但未来也许会用上。
-
Statistical Functions:max/min, sum, prod, std 等。我们需要经常用 sum。
综上来看,电子结构对数学库的需求是全面性的。除了 Searching, Set, Sorting 三大类功能外,其余的功能我们全都要。
除此之外,还有很多数学库不见得有,但计算化学有重要用途的功能:
-
矩阵分解。这个是 Lapack 的部分,意义不言自明吧。
-
特殊算子或 einsum。einsum 不是 Python array API standard 所要求的功能范畴内,但它对电子结构的帮助很大。DFT 的不少计算在标准的算子下是不效率的;或者需要实现强大的 einsum、或者手动实现这部分算子 (像目前的 rest_tensors 与 PySCF 一样)。
-
非线性矩阵方程。这是指求解 的问题;但注意 尽管可以写为 ,但出于计算上的困难或过大的存储空间, 不会直接被计算,因而 需要用求解方程的方式实现。这类问题的典型是 CP-KS 方程,当然也包括类似的 Casida 方程或波函数稳定性分析。这类问题可能是 SciPy 关心的问题,也可能需要我们自己实现算法。
6. 对性能的理解、对 Rust 的理解
6.1. 你是如何看待 Rust 的?
Rust 语言是新语言;就算是一般程序员也较少接触、学习难度大,更不要提计算化学程序员了。要将工作流迁移到 Rust,一般意味着 C++、Fortran、Python 或 Matlab 有无法满足我们的情形,并且这种不满足是不太能妥协的:
- Matlab 是商业软件,且不是通用语言;
- Python 性能与并行有缺陷,内存控制有困难;Python 的 MPI 并不方便;
- C++ 不是不能、但不容易正确地写出符合程序规范的代码,而我们目前没有资深的架构师;C++ 工程组织不像 Python 有 PyPI、Rust 有 Cargo 一样方便;C++ template 和 macro 灵活度太大而容易产生隐藏的编译问题、IDE 无法正确识别一些语法。
- C 不是高级语言,而且容易出现编译正确但执行错误、Segmentfault 等问题;
- Fortran 作为低级语言的部分与 C 有类似的问题,作为高级语言又不如 C++。
Rust 确实很好地解决了上述大部分问题;实际体验中还是有一些遗憾,但大多数遗憾不是决定性的。
选择 Rust 的重要因素之一,相信是其较高的性能。放弃 Python 而投向 Rust,一般来说最重要的原因是出于性能考虑;次要的原因是 Python 过于灵活的程序框架,会使得新手程序员容易写出不符合程序规范的代码,而导致代码库被污染。因此,在我看来对于使用了 Rust 而放弃 Python 的人 (对我来说作为从 Python 工作流的舒适区转换到 Rust 的人),性能是不可妥协的,至少不可能为了更高的开发效率而对性能有很大的让步。不然为什么不用 Python 呢。
我确实尝试写了 Rust 的数学库 RSTSR。其中一个重要的因素是希望能推进 Rust 下电子结构程序的开发效率。但这是尽可能基于程序性能较快的情况下推进开发效率,而不是反过来的。
6.2. 计算性能如何评估和提升?
尽管说 Rust 有较高的性能,但必须要指出
- C/C++/Julia 等作为编译语言,一般也有较高的性能。
- 语言不是决定性能的唯一因素。即使是相同的算法,程序的编写方式 (技巧) 也会决定程序性能。
为了避免在讨论程序性能时陷入到不可知论 (变成无效讨论),这里有必要说明,程序性能有其评估的策略。这与 Rust 一般没有关系;只要是有比较强大编译后端的语言 (如 GNU, LLVM),这里的讨论都是适用的。
这里的理解,大多从 CNN Winograd 算法的实现开始成型的。CNN Winograd 算法是一个很有意思的例子,它即是计算密集的,也是对带宽使用有较大需求;并且为了提高计算效率,需要使用汇编语言 (或接近汇编的指令集函数)。下述讨论的内容在该文档都有所体现。
-
追求性能的前提是高效的算法。算法有两层含义:
-
算法复杂度。比较典型的例子是 MP2 4c-2e AO2MO 的问题:
如果什么优化都不做,直接对上式进行计算,那么就会写出 8 重循环 (因为有 8 个角标 ),而且每次都会作 4 次乘法与 1 次加法,因此上式的 FLOPs 是 (即 8 次方复杂度)。但实际上,不对上式作任何近似,也可以用更少的计算量得到完全没有误差的结果:
这样只需要执行 4 次 的运算 (即 5 次方复杂度),大大简化计算耗时。
-
浮点计算量 FLOPs。一个简单的例子是,对于长度为 的方阵 ,
该式的计算量 FLOPs 是 。但如果作合并同类项得到 ,那么计算量就可以节省一半到 。它并没有将复杂度降到 3 次方以下,但对性能提升也是很大的。这看起来是非常简单的结论,但该方法在处理 RI-CCSD 的 项时,会有非常大的帮助。还有一类问题可以利用对称性减少计算量,譬如 RI-JK 积分、RI-MP2 能量求和、CCSD 的 pp-Ladder 项计算等等。
上述的讨论都不涉及具体的程序与具体的代码技巧,但却是最关键的性能提升要素**。在使用代码技巧加速程序前,应尽可能研讨算法与浮点计算量改进的可能性**。
-
-
确定浮点计算量或带宽占用量。电子结构的大多数问题,特别是没有利用到稀疏性、局域性的问题,是可以严格地给出浮点计算量的。这并不是说要算到严格正确,但至少要估计到不会相差 10% 以上。
以 RI-CCSD 的 项举例,上面有 6 行公式,但其中 的计算量其实是可以忽略的,剩下四行每个都是 的 FLOPs,因此估计该过程总计算量是 。剩下的不重要吗?不太重要。我们仔细看的话, 可以利用对称性,因此 的 FLOPs 大约是 ;它与其余 4 行的计算量比值大约是 倍,即当虚轨道数量大于 10 时 的计算量就是可以无视的了。
上式也有一定的内存带宽量,体现在 的计算上。注意到对于一个 NUMA node 的计算设备、16 cores CPU,一般带宽与性能上限分别是 10 GB/sec (1.2 G doubles/sec) 与 1 TFLOP/sec。如果浮点计算数量与内存带宽需求量相差 800 倍以上,那么内存带宽就不是决定性因素。在当前问题中,如果 ,那么内存带宽也就不再重要。尽管如此,内存带宽的分析在一些特定的内存密集问题上 (譬如 DFT 计算)、或者 MPI 通信时,仍然是重要的。 -
确定计算设备性能极限。程序性能的优化总有一个上界;这个上界也并非不可知。通过并行地执行 bandwidth64 程序,一般可以对计算设备的 L1, L2, L3 缓存计算与通信效率作评估。Intel OneAPI Advisor 也可以提供有价值的数据。一般来说,现在的 CPU 通常有 70 GFLOP/sec/core (取决于 CPU 频率与 AVX 通道数),而带宽是 16 GB/sec/socket (应该是取决于主板与 CPU PCIe)。关于这部分信息,也可以参考先前对海思鲲鹏设备性能的评估文档。GPU 的计算性能参数一般比 CPU 更透明,可以到官方手册上直接查到。
-
比较设备极限与实际程序的浮点运算效率 FLOP/sec。以 RI-CCSD 的 Rust 演示案例为例,我们可以确定最耗时的部分平均大约是 45% 的设备性能极限利用率 (16 core CPU 设备上 500 GFLOP/sec 左右)。一般来说,50% 设备性能极限的程序效率是可以令人满意的:
- 一方面,高性能 BLAS 的性能利用率也不过 60%–80%,再优化也很难有性能提升空间;
- 另一方面,计算化学的产值目前较低、且用途通常是探索性的科研,无效的计算、低效的使用情景是经常发生的事情,所以效率不要低到无法忍受即可 (50% 左右额外的效率损耗,即 20% 的计算设备极限性能);
- 再者,电子结构的一部分任务是迭代的;更多的迭代步数本身就是性能损耗,因此追求极限的性能也包括追求更好的数值迭代算法。
基于 Python 的程序,如果仅考虑单节点的情形,不少情况下其实效率是可以忍受的;但也有很多情况 Python 和 NumPy 踩中了无法忍受的低效率红线上 (这多少也是为什么 PySCF 有大量 C 代码打补丁的原因)。
6.3. 作为化学程序员,我们需要手动调优性能吗?
一般而言,不应该。化学家、包括在化学领域工作的程序工程师,不应该把精力浪费在程序优化的炫技上,而是让程序回归"公式翻译器"的本质上。这句话的前提是算法已经由化学家和工程师设计好了。
每个人精力都是有限的;如果每个人能处理好自己的工作,那效率推进起来就很快。我们化学家最好能将"公式翻译器"的工作全盘托付给专业数值程序架构师,专精于自己的工作。但这也意味着"公式翻译器"本身要足够好,专业的数值程序架构师必须能做好自己的工作,我们才能用得方便。
作为更细节的说明,电子结构程序的主要 FLOPs 消耗是在矩阵乘法上;而矩阵乘法一般由 BLAS 提供,我们没有能力手动调优性能。剩余的部分性能差一点都是可以接受的,但是像 Python 和 NumPy 那样还是不太令人满意的。所以我们手动调优性能的余地其实不大;对于高性能计算最关心的三层级缓存、pipeline streaming、prefetching,我们一概当它没有;适当的时候写一些并行即可。上面这种做法 CPU 下一般是没有问题的,但 GPU 可能要再议。
但具体而言,这个问题取决于如何界定"手动性能调优"的定义、以及在什么工具链下性能调优。
-
一种极端的情况是,我说我喜欢 np.einsum (或者其他库里等价的张量缩并工具),我不允许更复杂的表达式。但考虑到现在的张量缩并工具并不能达到极限的效率 (不过必须要承认,现在不少张量缩并工具已经能有理想的效率了,至少比极限性能的 20% 要高);而且有一些表达式写成 Einstein 求和可能不适合于同类项合并,确实会增加计算耗时;那么手动地拆分 Einstein 求和并作同类项合并是有必要的。
-
一种比较普遍但隐晦的情况是,我们也许会遇到维度不连续的情况。比如下述问题:
这个问题尽管确实可以通过拆分成 GEMM 实现 (因此 Einstein 求和也可能有可观的效率):
# T: jbp, B: iaP, I: ijabT = np.zeros([nocc, nvir, naux])for j in range(nocc): # can be parallelfor i in range(nocc): # can be parallel, but with reduceT[j] = I[i, j].T @ B[i].T但如果 并不是由 这种顺序存储,而是以 存储,那么不仅该程序效率比较高,还可以用更短且更清晰的代码逻辑搞定:
# T: jbp, B: iaP, I: iajbT = I.reshape([-1, nocc * nvir]).T @ B.reshape([-1, naux])T.shape = [nocc, nvir, naux]因此,在生成四维张量 之前,我们就应该考虑它到底存储为 还是 更合适。更极端一些的问题甚至可能都无法以任何方式用 GEMM 写出来 (必须要进行一次显式转置才能转换为 GEMM 问题),比如 ——这样的张量存储方式是必须要避免的。
这种类型的问题,是在写程序的时候必须考虑的,但又不是化学家本身应该关心的问题。"公式翻译器"本身只负责正确翻译公式,不负责张量的角标怎样排列才是最有效率的。这种问题是化学家和"公式翻译器"之间灰色地带的问题,需要实现电子结构方法的工程师解决。 -
工具链是否成熟、是否高效、以及是否有计算化学所特有的问题,也是需要考虑的因素。数学库质量不高,尽管这按理是数值程序架构师的责任,但化学家可能因为没有别的人手帮忙、而需要搭把手。这里以 NumPy 举例。
- NumPy 除了矩阵乘法很快之外,其他运算效率低下;这导致 PySCF 花了不少精力在 C 中处理 DFT 相关的格点积分问题。这多少要归结为 NumPy 自己的问题 (不能很好地并行向量运算)。早期 NumPy 的矩阵乘法也估计有问题,PySCF 的
np_helper.c没少帮 NumPy 擦屁股。 - NumPy 自己不提供 GEMM 接口;对于复数矩阵 乘法需要调 SciPy 才能解决 (这个问题在目前 Rust 下的 RSTSR 框架也不好解决)。所以到底是调用
a.conj() @ b还是scipy.linalg.blas.gemm,喂给 SciPy 的矩阵有没有转置成 f-contiguous,这种细枝末节的技巧确实还是会一定程度上影响程序效率的。 - 我们经常会用下三角矩阵 (c-contiguous) 或上三角矩阵 (f-contiguous) 储存对称矩阵;但实际使用它们时,需要展开到对称矩阵。这个功能化学需要经常用,不少主流数学库对这类型功能不怎么支持。这种压缩矩阵的展开在编译语言里实现倒还好,但 Python 里实现是不合适的;因此化学家必须要对这类问题发展程序工具解决。
- NumPy 除了矩阵乘法很快之外,其他运算效率低下;这导致 PySCF 花了不少精力在 C 中处理 DFT 相关的格点积分问题。这多少要归结为 NumPy 自己的问题 (不能很好地并行向量运算)。早期 NumPy 的矩阵乘法也估计有问题,PySCF 的
6.4. 我在一些问题上无法信任数学库的性能;应该自己写算子吗?
我的答案是,目前很可能还是需要的;但这取决于数学库的完成度。
我不否认一些数学库,在一些简单的运算问题上有非常糟糕的效率。不能信任数学库的性能是完全可以理解的。我对这个问题没有办法坚定地回答。
但我也认为,在很多简单标准的问题上,数学库有良好的性能是理所应当的。这件事不应该交给用户。数学库性能不好是数学库的问题,我们作为用户是因为没办法才需要擦它们的屁股。
不标准的问题也有很多,这特别是在机器学习领域里,算子融合是火过一阵子的问题;这类问题通常可以化归为标准问题、但有性能优化或数值稳定性优化的必要 (典型的例子是 softmax)。这类问题最早应该也是机器学习部署工程师手动解决的;但后来 PyTorch 堆人力堆算子也把问题解决了。
电子结构问题里,特别是 CC/MP 一类问题,都是矩阵乘法、数乘或加法、以及求和问题。这类问题都是非常标准的,很少有特殊的计算模式。即使是不标准的问题,那也通常不是 FLOPs 瓶颈。
矩阵乘法应该信任 BLAS 库。就算是在 AMD CPU 上用 MKL,我们也绝对不可能写得比 BLAS 还要快。作为计算密集但缓存调用不友好的算法,矩阵乘法的具体算法不仅复杂、而且需要非常精妙的技巧。除了涉及到利用三级缓存而产生的复杂的五重循环 (循环的 batch 依赖于当前计算设备的 L1/L2 cache),还需要利用汇编语言、结合对应 CPU 微架构作 pipeline streaming and prefetching;这已经不是我们应该了解的问题了。作为入门 (我也还没完全理解),请参考后藤和茂 (K. Goto) 和 Devin Matthews 的博后导师 R. van de Geijn 的教程。
但 DFT 的不少问题,尽管也可以用数学库高效率的函数实现,但不用数学库有可能更好。DFT 的性能瓶颈与 HF 和 post-HF 都不同;它尽管有两步是 GEMM 的矩阵乘法问题:
以及轨道格点的基变换问题:
这两个问题是 GEMM 问题之外,其他问题通常不是 GEMM 问题,通常是带宽瓶颈,但也占用较大的计算时间。这类问题中,一部分在 NumPy 中有可能通过 np.einsum 高效率地实现,但 np.einsum 并非在所有问题上都能保证有很高的效率。
6.4.1. 不适合信任数学库的算子案例:
一个典型的问题是自洽场密度格点的生成:
该问题其中一步可以化归为下述数值问题 (基于一些算法,矩阵 可以与矩阵 相等,从而进一步节省带宽):
该步的计算在数学库中,可以用标准的方式实现:
写为 NumPy 代码,则是
t = a * b
c = t.sum(axis=0)
当然,上述代码还可以简写为 c = (a * b).sum(axis=0)。这样的算法当然是正确的,但代价是需要生成一个临时张量 。这个临时张量需要额外的内存是小事 (因为 DFT 一般应该要控制分批格点数量);但额外的 的一次写入和读入是对计算资源的浪费。
下面我们将基于具体的例子来表明和比较不同数学库、不同实现方案的计算效率。当前问题的轨道数 (指标 ) 设置为 1000,格点数 (指标 ) 设置为 100,000。
我们首先考察该代码的最优解决方案。在 Rust 中,直接暴力循环进行计算:
let vec_c: Vec<f64> = vec![0.0; ng];
vec_c.par_iter_mut().enumerate().for_each(|(g, c)| {
    for i in 0..ni {
        *c += vec_a[i * ng + g] * vec_b[i * ng + g];
    }
});
该计算耗时是 31 msec。注意到矩阵 分别有 0.75 GB 的内存大小;遍历这两个矩阵本身就要耗时 15 msec 左右;因此上述实现至少达到了 50% 的极限带宽性能。我暂时无法确定,对于上述计算,是否有更快的实现方法。PySCF 中对该问题有稍不同的实现算法 (C 函数 VXC_dcontract_rho),其耗时是 29 msec。我认为以 30 msec 作为参考是合理的。
不要看这个问题最快只要 30 msec,所以就不用关心了。一方面,DFT 计算中类似的过程有不少;另一方面,这个函数实现得不好的话,耗时是有可能达到秒级的,下面就会看到。
NumPy 对这类问题其实还有别的工具:np.einsum:
c = np.einsum("ig, ig -> g", a, b)
这个函数在处理当前问题时,性能其实很好,大约耗时 36 msec。而且该函数完全是单线程运行的,意味着很可能有非常强大的 SIMD 优化、但没有作并行化处理。由于当前问题本身的特性,不并行也可能达到很好的效率;但并不是每个问题都是如此,np.einsum 会在其他问题上显现出其劣势。
如果我们不能用 np.einsum,而用普通的张量库逻辑,即对于 NumPy 而言,
# numpy                       #  100 msec in total
t = a * b                     #   79 msec
c = t.sum(axis=0)             #   21 msec
对于 Rust 的 RSTSR 而言,
// RSTSR                      // 127 msec in total
let t = &a * &b;              //  97 msec
let c = t.sum(0);             //  31 msec
对于 Rust 的 ndarray 而言,
// ndarray                    // 340 msec in total
let t = &a * &b;              // 308 msec
let c = t.sum_axis(Axis(0));  //  21 msec
对于 Rust 的 nalgebra 而言,
// nalgebra                   // 410 msec in total
let t = a.component_mul(&b);  // 343 msec
let c = t.row_sum();          //  70 msec
尽管 NumPy 与 RSTSR 有比较可观的效率,但无论如何都会比最高效的代码慢 3–4 倍。因此,当前 的问题,为了实现效率,很有可能必须要在 Einstein summation 的框架下实现、或者手写函数实现,而不能用普通的矩阵乘法、向量 elementwise 运算、求和等基础算子实现。
6.5. Rust 哪些特性不适合数学库的建设?
-
Rust 不是专注于科学计算语言。像 transpose, inversion 等等既不能用符号 (operator) 替代、也不会在语言标准库 (standard library) 中实现;甚至复数的运算都需要外部库实现。
-
Rust 难以通过符号实现语法糖。Rust 的一些 operator 对应的 Trait 被写死了;这导致 NumPy 中可以简洁地用 operator 实现的功能,在 Rust 中也必须用函数完成,大量地增加了语法噪声。举例而言,
-
索引。NumPy 中可以通过
a[1, 2:4, 3:10]索引一个三维张量到二维矩阵;这个索引是通过 operator[]完成。Rust 尽管也有 operator[],但它是通过 TraitIndex完成的:pub trait Index<Idx>whereIdx: ?Sized,{type Output: ?Sized;// Required methodfn index(&self, index: Idx) -> &Self::Output;}它的输出是
&Self::Output,不是Self::Output!这意味着你不能只返回一个已经存在的变量,而不能返回一些创造出来的量。我们后面会说到,索引后的张量的原始数据 (raw) 确实是不变的,但会产生新的形状信息 (shape) 与偏移 (offset);这些都是需要花费新的内存空间保存起来的。因此,张量索引后的返回值无论如何都很难用引用类型&Self::Output保存。从而,Rust 中对张量的索引,除非你就是想拿出一个值出来可以用 TraitIndex或者等价的 operator[]做到;否则想要索引出一个子张量,还是得老老实实用函数。在 candle 框架下该函数是.i(),在 ndarray 下是.slice();RSTSR 下.i()与.slice()这两个函数等价。 -
赋值。C++ 的符号重载太强大,以至于 C++ 的张量缩并库可以把 operator
=玩出花来。但 Rust 是另一个极端:=只有赋值的功能而不能重载。这可能出于 Rust 保证生命周期的原因而设计,但这对我们科学计算用户很不友好。最简单的例子是,对一个张量的索引作赋值:c[:, :nocc] = a[:, :nocc]这样的代码在 Python 中是非常直观的,但 Rust 不允许赋值给一个 statement。在 Rust 的 RSTSR 中,这尽管不是不能解决,但还是绕了弯子或者增加了语法噪声:
// by assignc.i_mut((.., ..nocc)).assign(a.i((.., ..nocc)));// if c is zeroed before assignment, use add_assign is also validlet mut c: Tensor<f64> = rt::zeros(([nao, nmo], &device));*&mut c.i_mut((.., ..nocc)) += a.i((.., ..nocc));请注意 Rust 中的 Trait
AddAssign是可重载的,因此上面的问题有两种解决方案。我个人会更喜欢第二种方案,它由于可以用+=符号而更像 Python 代码,但有性能上的损耗。对于 ndarray 也是如此。 -
比较。以函数
eq为例,在标准库的PartialEq中,fn eq(&self, other: &Rhs) -> bool;它的返回类型被写死为布尔类型。但在 NumPy 中,像这样的代码
c = a == b # returns a tensor of boolean type, not bool itselfc = a is b # this returns boolean, but comparing id(a) and id(b)特别是上面第一行代码,在 Rust 中必须通过其他函数,而不是符号来实现。
-
-
Rust 因其所有权机制与错误处理机制而增加了语法噪声。该问题在标准库中也有讨论,参考
Vec::try_with_capacity(_in)的 issue。这是一个间接而非直接的后果。Rust 的所有权与错误处理机制其实是其优势;但作为库开发者,当开始写函数时,就会发现,你需要写至少 4 种情况。以transpose为例:- 输入值、输出值、允许错误处理的函数
into_transpose_f; - 输入值、输出值、错误就直接 panic 的函数
into_transpose; - 输入引用、输出 TensorView、允许错误处理的函数
transpose_f; - 输入引用、输出 TensorView、错误就直接 panic 的函数
transpose;
作为用户其实一般只用
transpose就行,这跟 NumPy 是一样的。但作为库开发者,输入引用还是输入值这两种情况要写两个函数,这是应该做的;你不知道用户有没有对错误处理有特殊的要求,所以最好搞定错误处理的情形 (命名上,RSTSR 与 tch-rs 的习惯是后缀_f,标准库里不少函数是前缀try_)。而reshape或to_layout函数还要多处理两种情形:输出 Copy on Write 类型或输出值类型。所以 Rust 尽管很强大,但库开发者每次写一个功能都要搞至少四个函数,很多还不太好用 macro;库使用者也至少得知道transpose和into_transpose哪个是值类型、哪个是引用类型,还是挺费劲的。 - 输入值、输出值、允许错误处理的函数
-
利用 Trait 的重载 (overload) 不是非常方便。Rust 语言本身的特征是禁止 override 与 overload。作为非 OOP 语言,禁止 override 是绝对的;但作为泛型语言,overload 是可以绕个弯子用泛型方式实现。以 asarray 函数为例,我们可以先定义 trait
pub trait AsArrayAPI: Sized {type Out;fn asarray(self) -> Self::Out;}随后对各种 tuple 类型作特化。举例而言,如果我们希望从
Vec<T>类型的输入得到一维张量,那么就对Vec<T>类型 (作为 1 元 tuple) 作特化:impl<T> AsArrayAPI for Vec<T> {...}// this allow usage of `asarray(vec)`但如果我们希望从输入张量直接得到二维矩阵,那么就要对
(Vec<T>, Layout<D>)的 2 元 tuple 作特化:impl<T, D> AsArrayAPI for (Vec<T>, Layout<D>) {...}// this allow usage of `asarray((vec, layout))`作为具体的用例,
use rstsr_core::prelude::*;use rstsr_openblas::DeviceOpenBLAS;let vec_a = vec![0.0; 15];let vec_b = vec![0.0, 15];let vec_c = vec![0.0, 15];let device_openblas = DeviceOpenBLAS::default();// generates 1-D tensor of shape [15] on default device (DeviceFaer)let tensor_a = rt::zeros(vec_a);// generates 2-D tensor of shape [3, 5] on default device (DeviceFaer)let tensor_b = rt::zeros((vec_b, [3, 5]));// generates 2-D tensor of shape [3, 5] on DeviceOpenBLASlet tensor_c = rt::zeros((vec_c, [3, 5], &device_openblas));这确实达到了用 trait 系统做到 overload 的目的,而且从某种程度上比 Python 还要灵活 (Python 是明面上不允许 overload,但允许 optional parameter 的),但这存在至少两个问题:
- 必须要输入 tuple 类型参数,即实现这些函数至少要上两个括号。但对于 1 元 tuple,两个括号又是多余的,会被 VSCode 编辑器提醒。这增加了语法噪声,也造成代码风格的不一致性;但这总比定义三个函数
asarray_to_1d,asarray_with_shape,asarray_with_shape_and_device要好太多。Python 里面在索引时有语法糖tensor[(a, b, c)]等价于tensor[a, b, c],不知道 Rust 有没有这样的规划。 - 定义一个可 override 的函数会很复杂。本来是多声明几次函数 signature 的事情,现在要多出一个 trait。这对 API 开发者而言是额外的负担。而且 API 文档要怎么写,我心里也没数。
- 必须要输入 tuple 类型参数,即实现这些函数至少要上两个括号。但对于 1 元 tuple,两个括号又是多余的,会被 VSCode 编辑器提醒。这增加了语法噪声,也造成代码风格的不一致性;但这总比定义三个函数
-
API 文档友好性存疑。这是比较主观的判断。API 文档其实所有语言、所有框架都未必做得很好。我们能看见不少 Python 或 C++ 库的文档很不错,但里面也有很多人工的成分。Cargo doc 我们能干预的地方不多,它能保证 API 文档的下限,但也制约了 API 文档的上限,未必适合大项目。
-
Trait 系统还有提升空间。Rust 的 trait 系统比 C++ 更容易写得规范,把问题在编译前解决,这是 Rust trait 系统的好处。但坏处是限制比较多。作为例子,在实现
abs绝对值函数时,我们注意到num::Signed与num::complex::ComplexFloat有两种abs的实现。作为数学库,我们既要对整形 (只实现Signed)、也要对浮点型 (同时实现了Signed与ComplexFloat)、还要对复浮点型 (只实现了ComplexFloat)、同时也许要兼顾到无符号型整数 (只实现了Unsigned) 的abs函数。Rust 尽管允许你这样做:impl<T> DeviceAbsAPI<T> for DeviceCpuSerialwhere T: Signed {...}但如果你还想同时实现
ComplexFloat:impl<T> DeviceAbsAPI<T> for DeviceCpuSerialwhere T: ComplexFloat {...}Rust 就会告诉你有 conflict implementation。首先,浮点型因为同时实现了
Signed与ComplexFloat,所以确实存在实现冲突。其次,你会发现,浮点数天生不可能是Unsigned的,那么我应该可以对Unsigned实现吧?但这也是不允许的,因为 Rust 不知道哪个下游用户在哪天出于什么不可告人的目的,新建了一个类型myf64,把Unsigned和Signed同时实现给了myf64类型,从而你的库真的有了 conflict implementation。因此,现在对于abs绝对值函数的实现,有三种策略:- 直接对具体的类型作特化 (specialization),不用 where clause;
- 声明两个 trait (
DeviceRealAbsAPI,DeviceComplexAbsAPI),它们都实现了abs函数。 - 自己新建一个 trait,统一 abs 函数的用法。
目前 RSTSR 采用第 2 个策略;但我很难说这是一种好的办法,因为它要么割裂了浮点类型与复浮点类型,要么割裂了整数类型与浮点类型。我相信这也是 crate
num费解的问题 (issue #64 有所讨论)。
第 3 个策略其实不是不行,但这有另一个问题:我们要不要对传值的 unary 运算作内存的优化?如果是f64类型,其绝对值也是f64类型,那么下述运算就是可行的:a = a.abs()这不会新开辟新的内存来储存变量
a。但如果是Complex<f64>类型,它绝对值之后就不是原来的类型,而是f64类型,意味着用正常的代码风格,无法复用原来的内存。因此,如果为了尽可能复用内存,f64与Complex<f64>就算是能用同一个 trait 统一接口,也要走不同的代码逻辑。
我不清楚这样的问题是否未来可以通过 negative bound 实现 (从而可以有基于容斥原理的 trait 限制策略,而不是现在过分严格的 orphan rule)。
6.6. 我对迭代器的一些迷思
我对迭代器是否比 for loop 效率更高有所怀疑。
有不少问题,在 for loop 下可以写得比较直观,而且效率损失不会很大,如果真的有效率损失的话。况且,如果迭代器真的更快,那么我相信 rustc 会识别到 for loop 并将其循环的部分打包成为 FnMut closure,以迭代器的方式编译。
在我看来,迭代器在下述用途确有意义:
- 非 1-D 向量的迭代。张量结构不是一维向量,有多种不同的迭代可能;而且如果用 for loop 写,会写成 (编译时还不知道几层的) 多重循环。这种情况下,迭代器是刚需。
- 并行。当程序语言对并行的支持不能在语法糖上支持时 (譬如 Julia 等),或者不能通过宏或者预编译指令支持时 (譬如 OpenMP 等),那么就需要用函数实现。函数作用的必须是对象,因此循环本身就要被打包为对象,这个对象就是迭代器。Rayon 迭代相信也是学者前辈们这么来的。
有一些时候,迭代器可能用起来更方便,譬如要 collect::<Vec<T>>() 的情景;否则我们要在循环外生成一个空的 mut Vec<T>,循环体里要加一句 push(item),比较麻烦。但这仅限于循环逻辑非常简单的情况;如果循环逻辑稍微复杂一些,for loop 反而更直观;况且大家都是学 C/C++/Python 语言上来的,更习惯 for loop。
也因此,当迭代器不是刚需的时候,我确实会出于代码习惯 (而不是更加理性) 的原因,反对或支持使用迭代器;特别是在没有 micro benchmark 测试并证明迭代器是否比 for loop 更加高效的情况下。
同时需要指出,电子结构所遇到的问题,一般迭代器是可以设计为高效并行的;但这要付出开发时间以及程序员之间磨合的成本,程序效率也不一定真的就缺那一点,毕竟主要的耗时来自于 BLAS、除此之外提升程序效率的关键还是算法本身的设计。因此说实话,我对设计特殊迭代器持保留态度,我倾向于用 for loop;关于这点,以后如果开始深入了解自洽场算法的瓶颈,我会再研讨这个问题。
这里讨论两个迭代器相关的问题。
-
并行迭代器设计。这个是 Rayon 库的内容,不是我的经验了。首先,我的体验是 Rayon 的并行某种意义上比 C OpenMP 要强大;它至少支持双重迭代循环、有类似于 MPI 的灵活的函数接口、性能上至少在简单问题里跟 OpenMP 没有看出明显区别。对于 OpenMP 的简单 for 循环,Rayon 可以直接转换为等价的
(0..n_i).into_par_iter().for_each(|i| {...})虽然有一些语法噪声,但确实是一行能搞定的问题。不同于 OpenMP 的是并行循环体必须是
Fn而非FnMut的,不能传 mut 或者没有实现Sendtrait 的类型,有可能需要 unsafe 或其他支持才能实现完整的类似于 OpenMP 的 shared 的并行模式。我们有时需要并行地迭代一些结构,而且这种结构不是简单的 for loop 能解决的 (就比如迭代整个张量元素)。在这种情况下,尽管实现
Iterator也能并行,但需要用到 bridge 机制;bridge 是非常低效率的。为了让迭代器有更高的效率,Rayon 需要我们提供下述 trait 实现:DoubleEndedIterator即双端迭代器;ExactSizeIterator即需要预先知道迭代器长度;Producer,它需要实现split_at函数。迭代器可以看成一种映射关系,即迭代列表与连续整数数组之间的一一对应。Rayon 并行需要整数数组到迭代列表的映射 (但不需要其逆映射);即从被迭代的第 个元素,能反推其被迭代的内容。以大小为 的二维矩阵为例,row-major 的第 个索引对应的元素是 。ParallelIterator与IndexedParallelIterator;这是 Rayon 中上层 trait。
-
尽量使用 array
[usize; N]而避免 slice[usize]。这是高维度张量索引时会遇到的问题,并非普遍的计算化学或程序都会遇到的问题。关于这个问题,我们会在 即矩阵转置求和的问题中碰到。
7. RSTSR 特性
7.1. RSTSR 的设计目标是什么?
- 函数风格上:尽可能与 NumPy 一致,尽可能简单易用且符合 NumPy 习惯。
- 功能上:绝大部分 NumPy 主程序、SciPy 的 scipy.linalg 与 scipy.linalg.blas。
- 其他编译语言的数学库大多也是对标 NumPy,以 xTensor (C++), ndarray (Rust), GoNum (Go) 与 NumSharp (C#) 为代表。NumPy 当然不是最好的数学库,但跟它作参考也没什么可耻的。
- CPU 性能上:矩阵乘法外接 BLAS;其余大部分算子在 8 cores 并行的情况下比 NumPy 串行快。允许比较灵活地接入 Rayon 并行代码。
- 后端上:希望未来能支持 GPU 编程 (包括 CUDA, HIP)。
- 类型上:通过 trait 泛型支持所有类型的数据储存;通过
std::ops与 cratenum支持部分类型的计算。
电子结构程序不仅追求上述目标,还同时要实现电子结构自身的算法,甚至使用标准数学库所不具有的算法。我的知识广度并不够,但之前听到任兴国老师的学生 (poster) 在实现基组极限 RPA 时使用了 oneMKL PARDISO。显然化学所需要的功能比一般数学库要更广。因此,就算是为了电子结构程序的编写,这些简单的数学程序工具也是有发展价值的。
关于 RSTSR 的目标、对其他 Rust 或非 Rust 语言的数学库的调研简报,在 RSTSR 第一次报告中有更细致的说明。
同时也要说明,尽管 RSTSR 是出于电子结构程序的目的而设计的,但它还是数学库,不是电子结构库。电子结构程序本来就可以将其数学问题分离出一部分自成体系,可以解决的问题也不止是电子结构,因此我们也不应该强行说 RSTSR 是具有电子结构计算特色的数学库。我们的目光可以也完全应该更长远一些。
7.2. RSTSR 现在有哪些功能?对电子结构还有哪些不足?
前后总计大约 3 个月的开发时间下 (7/28–8/5, 8/11–10/6, 12/22–1/21,期间完成过 REST 下 RHF 一阶梯度实现草稿等其他工作),目前 RSTSR 已经完成了大部分 Python array API standard 所对数学库要求的基本功能。请参考 电子结构程序需要用到数学库哪些功能? 中电子结构对数学库的需求。
我自己也基于下述三步骤的工作流程:1) NumPy np.einsum 打草稿、2) NumPy 去除 np.einsum 为迁移到 Rust 作准备、3) 基于数学库 RSTSR 具体地实现算法,以非 RI 的闭壳层 CCSD 教程文档为起点,基本没有借助已有文献的推演,在 Rust 语言下实现了闭壳层 RI-CCSD (showcase_rust_riccsd),前后历时 4 天以内 (2025/1/17–2025/1/20),程序性能至少与 Psi4 fnocc 模块相当,不过内存开销还是没有更细致地优化过。我希望该项目能够表明,NumPy + Rust 的工作流策略,辅以功能相对完整的 Rust 数学库,是完全有可能做到高效、快速实现电子结构方法的。
目前 RSTSR 还有很多不足需要解决。
- 未满足所有 Python array API standard 的函数要求,包括 concat, stack, argmax 等。
- 未实现 BLAS 与 Lapack 封装、以及线性代数部分;这意味着现在 RSTSR 还没有确定的方案,如何求矩阵本征值或向量求解问题。因此,目前的 RSTSR 还没有办法作 SCF、CP-HF、Cholesky 分解、RPA 需要用的矩阵对数或行列式值等计算。
- 没有正确性与效率测试。在开始 RI-CCSD 实现之前,我一直在往 RSTSR 中补功能,还没来得及作任何正确性的验证。所以 RSTSR 有数值错误是完全有可能的。当然,实现 RI-CCSD 的过程中,只有一次比较良性的 bug 修复 (去除一个过分严格的 trait bound),所以我对程序正确性还是抱有很大期望的。
- 未实现 NumPy 中一部分 advanced indexing 功能,特别是通过整数列表索引张量的功能。
- 未实现异构后端。现在尽管已经实现了多后端,但它一般只是用来切换不同的 BLAS 引擎,验证了多后端实现的可能性。真正的多后端应该要考虑 CUDA 与 HIP、对于 MacOS 要考虑 Accelerate 与 Metal。
- 还需要在更多的电子结构问题上作实现和测试。
- 尚未验证过在 MPI 并行下的适应性。
7.3. 为什么不满足于已有工具?RSTSR 有哪些特性是有优势的?
-
支持完整的 n-dimensional array 及其 broadcasting。这是相对于 ndarray 而言的;它只支持部分 broadcasting 和 manipulation functions,应该视为半成品。不少其他 Rust 的数学库不支持 n-dimensional array,特指 nalgebra, faer 等。还有一些库不支持动态维度张量 (可能是出于构建计算图的原因),特指 dfdx, burn 等。
-
支持浮点类型与复浮点类型。Rust 现在的机器学习库一般不支持复浮点,特指 candle, burn 等。说实话,candle 是最接近计算化学可用张量库的框架,但它的设计模式与 PyTorch 一样,可扩展性不强 (尽管在 10 年前是非常优秀的设计),类型与后端是写死在核心程序的。这与我的开发理念有比较大的冲突。从可扩展性上,我们更接近 burn;但 burn 在数据类型和可变维度上又不满足我们的需求。
-
我们打算支持多后端。这是相对于 NumPy 与 ndarray 而言的。nalgebra 前几年放弃了 CUDA 后端。PyTorch 现在是无敌的存在;如果我们自己写的函数面对 PyTorch 啥都打不过,也许以后也可以把 PyTorch 作为我们的后端。但不论哪种引擎作为后端,基本的任意维度张量、reshape、transpose 等功能仍然要在 Rust 语言下实现;这个 C++ 是帮不了忙的。
-
内部算子的 CPU 并行。该功能意味着我们除了 BLAS 计算可以靠现成的库加速以外,其余部分的性能也比较可观;但我们没有花太多精力在这件事上,极限的效率显然现在还达不到,但至少不会被拖累太多。以 NumPy 和 ndarray 为代表的几乎所有的数学库都只在 BLAS 并行,没有在其他地方作并行。但少部分有该功能的数学库性能比我们的好,以 PyTorch 为代表。
-
外部 Rayon 并行无缝衔接。该库的函数大多可以在 Rayon 线程内部运行。
-
BLAS 支持串行与并行调用。这个是向 rest_tensors 学习的。在 Rayon 并行内部将会限制 BLAS 核数为单核;在没有并行环境的情况下则满 CPU 运行;并发核数大小也可以在 device 中控制。在我的理解里,ndarray 与 nalgebra 不支持该功能;这类型功能需要对每个 BLAS 发行版作特化才能实现,而不是靠 crate
blas-sys一招走天下的;否则一到 Rayon 并行地调用 BLAS 时就容易出问题。 -
简洁的、接近 NumPy 的接口形式。以 sum 函数为例,我们的 sum 函数要求传入被求和的维度列表;比如说在计算偶极矩时,我们会要计算电子积分与密度矩阵的数乘求和:
// tsr_int1e_r: (t, mu, nu); rdm1: (mu, nu)let dipole = (tsr_int1e_r * rdm1).sum((-1, -2))但在 ndarray 中,就需要写成
let dip = (tsr_int1e_r * rdm1).sum_axis(Axis(2)).sum_axis(Axis(1));不仅代码比较复杂,其计算消耗也有所增加。再例如
asarray函数,我们使用 trait overload 的模式进行重载;但 ndarray 则需要使用from_vec,from_shape,from_shape_vec,from_shape_ptr等等众多函数做一件事情,对用户不友好。
7.3.1. RSTSR 有一定优势的算子:矩阵转置数乘
之前在算子 问题上被 NumPy 的 np.einsum 吊着打,现在是时候扳回一城了。
在 MP2 计算时,会出现下述计算问题:
该算子其实是数乘后求和的融合算子,按原来的公式实现是最好的;但在程序实现时为了方便,对于每个成对占据轨道 ,作两次矩阵数乘:一次非转置,一次转置:
这是当前我们考察的算子 与 的来源。
按理这个算子不是很花时间,毕竟它是平方耗时 (乘上成对占据轨道,FLOPs 是 ,比 RI-MP2 整体的 的 5 次复杂度要小很多)。
但如果用 NumPy 实现,效率就会变得很糟糕。首先,RI-MP2 本来对成对占据轨道 是很容易并行的;但受制于 Python 语法,纯 Python 我们就不要想着对 for loop 作并行了。NumPy 的矩阵乘法用了 BLAS,就算不对占据轨道 并行,从 Cholesky decomposed ERI 获得 MO 基的 4c-2e ERI 也还是很快的,也就是说 NumPy 在计算瓶颈部分效率是有保障的。
但是计算非瓶颈部分的矩阵数乘,NumPy 就会出现效率问题。现在假设一个 512 电子的体系,, , ;在我的 16 core CPU 笔记本电脑上,假设 BLAS 能达到 55% 性能 (600 GFLOP/sec),那么 RI-MP2 计算瓶颈部分的时间是 328 sec。
这样看来,能量求和计算应该不是瓶颈了吧?但跑了一下代码会发现,NumPy 下 矩阵计算
- 正常矩阵数乘 是 250 µsec,
- 转置矩阵数乘 是 5.3 msec,
- 矩阵求和 是 130 µsec,需要进行两次计算,
结合 个成对占据轨道的循环,上述计算估计需要 190 sec。这已经达到计算瓶颈耗时的 60% 了,并不是可以忽略的小数目。
NumPy 中,存在效率问题的部分是转置矩阵数乘 以及求和 效率较低;不过从求和效率上能提升的效率不大。在 Rust 中,我们天生地可以对成对占据轨道 该问题作并行,从而缓解该问题。这是一种解决方案。
但就算不对成对占据轨道 作并行,而只是普通的 for loop,RSTSR 在 RI-MP2 能量求和上也可以达到很好的性能。
RSTSR 中,如果输入的 与 是固定维度 Ix2,并行执行下,
- 转置矩阵数乘 可以提升到 310 µsec (ndarray 是 3.7 msec),
- 矩阵求和 是 38 µsec (ndarray 是 84 µsec)。
对于转置矩阵数乘问题,RSTSR 的性能提升是大于 16 倍理想并行效率的。作为带宽瓶颈问题,正常的并行性能提升,取决于具体问题,在 0.8–8 倍 (对于连续性很好的简单计算问题,并行有时是负优化)。这可能与 RSTSR 的迭代器设计有关。
对于 RSTSR,我们估计上述 RI-MP2 的能量求和问题耗时是 21 sec,比 NumPy 快大约 9 倍,比计算瓶颈的 MO 基 4c-2e ERI 的 328 sec 要小许多。这样才算是解决了对于性能不关键的部分,即使不用最优效率的算法而使用最方便实现的算法,程序的效率也要能令人满意的问题。但需要指出,PyTorch 很有可能有与 RSTSR 接近或更快的实现效率。
7.4. RSTSR 从设计上有哪些设计缺陷,可能在早期研讨或彻底重构?
在现有 RSTSR 框架下,一些问题我没有想出很好的解决方案。我也希望对于下面我想到的问题,以及我可能没有想到的问题,尽早作讨论:
- 复矩阵共轭。目前 RSTSR 的实现与 NumPy 一致,即
a.conj()会产生一个新的、内存重新分配的矩阵。因此,像a.conj().T @ &b这种计算会天生地低效且消耗内存。这件事当然可以通过引入安全的 BLAS 接口,让用户选择是否选择更高效的 BLAS 函数来解决;但这多少会造成一些语法噪音。 - 矩阵类型。我们不总是处理任意稠密矩阵,也可能处理对角矩阵、三对角矩阵 (tridiagonal)、对称矩阵、反对称矩阵、厄米矩阵、反厄米矩阵、下三角矩阵、不含对角的下三角矩阵、上三角矩阵、不含对角的上三角矩阵、带状存储的稀疏矩阵等等。我们作为张量库,未必需要对二维矩阵作非常完全的支持;NumPy 在这方面多少也是被诟病的,后来的 GoNum, nalgebra, Faer 就对其中一部分矩阵类型作了不同于普通矩阵的实现。但如果我们确定要支持这些类型的矩阵,就意味着我们需要重新研讨张量的存储与计算逻辑。
- 但同时指出,GoNum, nalgebra, Faer 都明确是仅处理二维矩阵或一维向量的库。我没有找到 n-dimensional 张量库有支持不同矩阵类型的情况。
- 这里补充指出,PySCF 一般在处理下三角压缩矩阵 (row-major) 时,会先对其解压缩,随后进行计算。这种做法大多数时候不会引入太多额外的效率损耗。
- 自动导数。说实话这个受制于我的个人能力。我还没有把握住计算图的原理。电子结构当然不需要自动导数,但这是现在 AI 方向对数学库的基本需求。我们当然不是不能做一个 inference only 的库,实现几个没有导数的算子不应该是难事,但这就很没意思了。如果想要往 AI 方向靠,我认为需要有经验的人的介入;但说到底,我自己是做电子结构的,确实没有动力做自动导数。我不清楚做 AI + 第一性的需求有多大,也不清楚现在 candle 和 burn 是否能胜任 Rust 下自动导数张量库并应用于化学问题。
- 编译时间太长。这个我也不知道原因和解决方案。有可能是在一个类型里有太多 impl。
以下一些问题是我有能力解决的,但也需要尽早讨论:
-
Col-major。现在的 RSTSR 默认是 row-major 即行优先的。在 RSTSR 中,具体的算法都是列优先实现的;列优先确实有更好的效率。但我们彻底地分离了具体算法与上层接口;目前上层接口只在 row-major 的环境下设计并实现。我们是否要明确支持 col-major,并且为 col-major 实现其对应的 broadcasting 规则,这我有自信实现,但如果有需求,需要尽早讨论。
- 我们需要说明,RSTSR 内部实现张量加减法时,会尽量将张量先转置为 col-major 再进行计算。因此,不管上层接口是 col-major 还是 row-major 的,都不影响计算效率。张量转置当然会有性能损耗,但这个性能损耗无非是五六个整数的加减乘 (layout manipulation),在电子结构问题里是无足轻重的。
- Col-major 的 broadcasting 应该要重新设计。NumPy 的 broadcasting 规则明显是对 row-major 更友好的。我不知道有没有其他张量库有过类似的尝试。
-
数据类型与 cast 原则。譬如
np.log(2)会给出浮点数,但现在的 cratenum对整形数或其对应的 trait 不提供 log 函数。对于哪些函数、用哪些 trait、怎么实现,这些问题需要再研讨。电子结构一般不使用常用和特殊函数;即使要使用,尽管不太美观,但我们也有.mapv(|x| x.log())这样的办法。Map 函数的设计是仿照 ndarray 实现的。 -
复杂的 trait impl。现在的 RSTSR 在一些问题上,似乎 trait impl 太过于繁琐,以至于 Rust 编译器已经无法自动推导类型。这在我写 RI-CCSD 时遇到了,也是在我看来实现 RI-CCSD 最不顺利的部分之一。举例而言,
let c = 2.0 * &a.slice(3);这件事在 RI-CCSD 实现中,很有可能会因为无法推导类型而报错。你必须加上这么一句才能编译通过:
let c: Tensor<f64, _> = 2.0 * &a.slice(3);我在开发 Rust 程序时,除了
collect::<Vec<T>>()函数有这个要求外,从来没有发生过类似问题。我认为需要想办法避免这种因 impl 过于复杂而报错的情况。
8. RSTSR 设计
8.1. RSTSR 的数据结构是什么?适用于任何稠密张量吗?
RSTSR 目前的数据结构如下图所示:
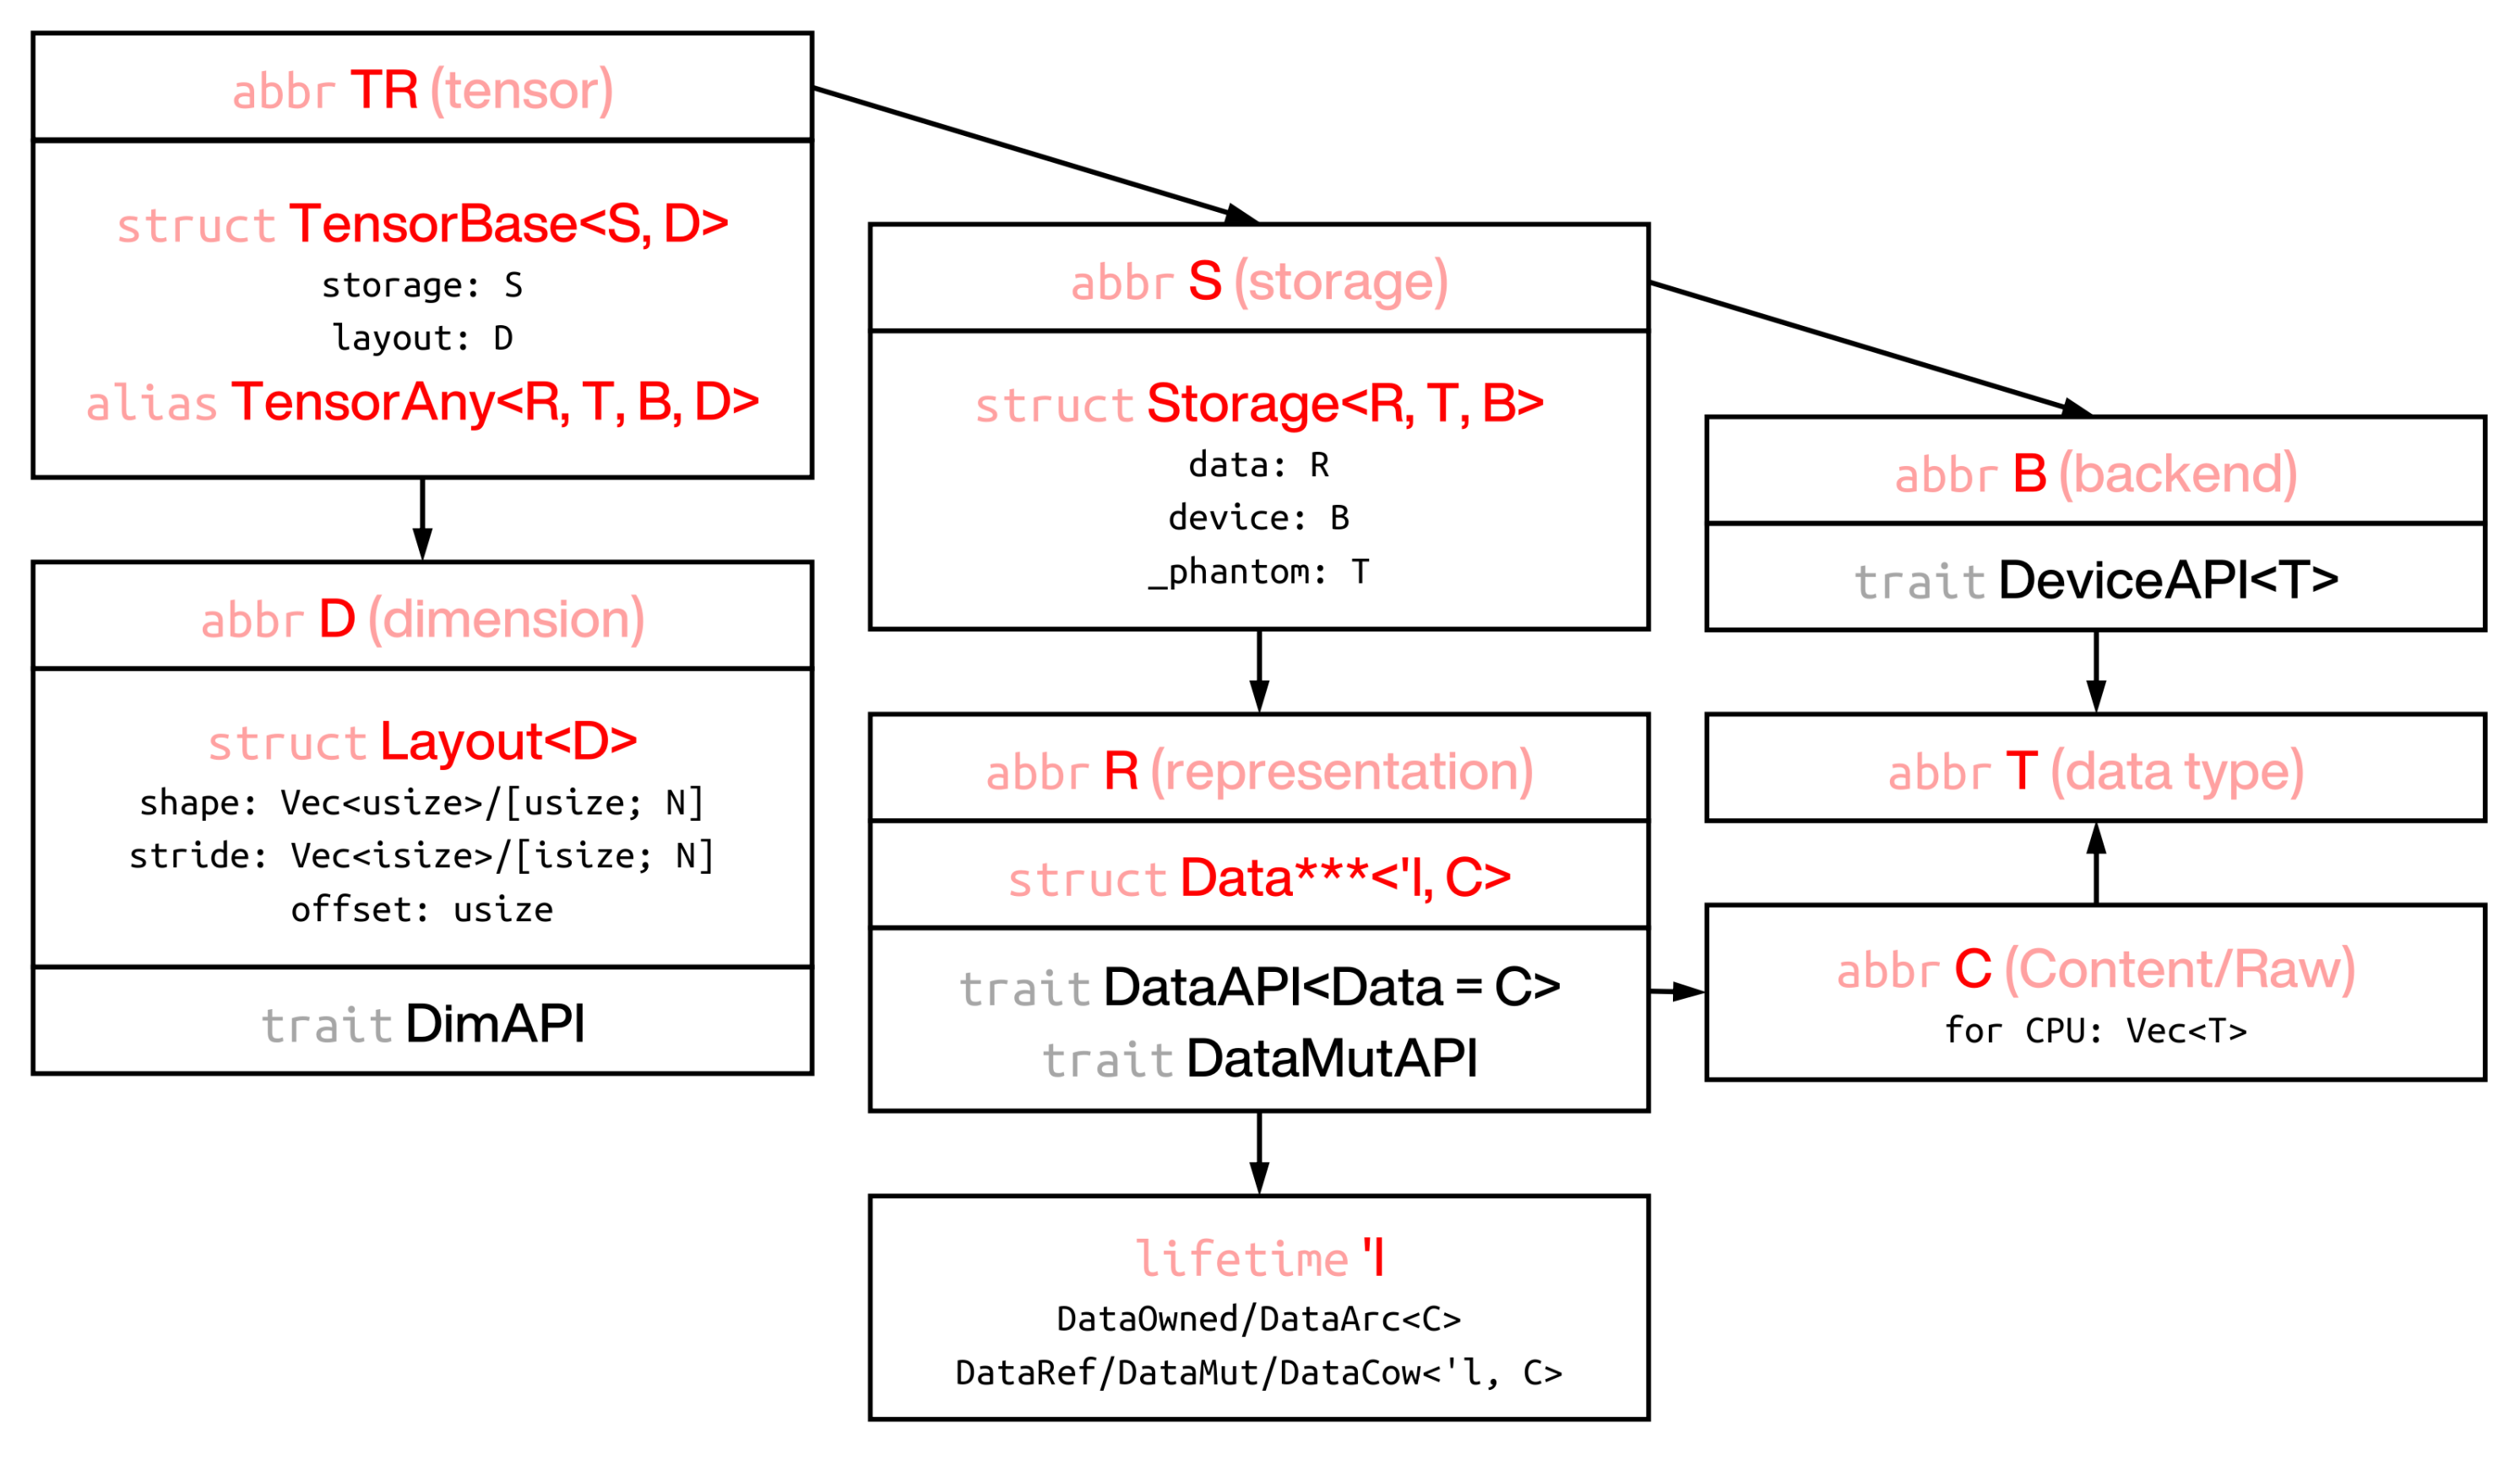
相信上述图片已经很直观了,这里不再详细展开。
RSTSR 代码经历过一次彻底重构,它与最开始的数据结构并不相同。请参考 RSTSR 第一次报告的第 12–13 页。具体来说,现在的 data 在 storage 之下,以前是反过来的。
RSTSR 的数据结构并不适合所有类型的稠密张量,特别是小型稠密张量。RSTSR 的张量中,除了储存原始数据的 tensor.data 之外,还要储存 shape, stride, offset, device。我们可以称之为张量的 metadata。
- shape 是
Vec<usize>或[usize; N],长度取决于张量维度;一般不超过 512 bits; - stride 是与 shape 相同,但类型是
isize;一般不超过 512 bits; - offset 是 usize,长度为 8 bits;
- device 取决于具体的后端:
DeviceCpuSerial只是一个标记符,不占用栈空间;- 涉及到并行的后端,都需要使用
DeviceCpuRayon;它由 CPU 线程数、全局线程池的 Arc、单线程池的 Arc 构成,总共 24 bits 栈空间;开辟全局线程池和单线程池估计至少需要 2048 bits 堆空间,但 Arc 指针会保证各个张量共享相同的堆空间,因此这部分堆空间可以不算在张量内部。
- 因此,一个
TensorBase类型除了数据之外,需要额外的 1024 bits 即 16 个浮点数。
对于电子结构,基组数超过 100 时,在内存中储存一个张量所需要的冗余信息不超过 2‰,这应该是可以接受的。但对于游戏渲染,一般经常会固定其中一个维度为 3 维,另一个维度也经常是固定且不超过 6 维的;这种情况使用固定维度会更好,即通过 dispatch (specialize) 不同固定维度的矩阵类型增加编译后二进制文件的大小 (以此代表张量的 metadata),而在存储张量时只需要原始数据。nalgebra, dfdx 等库支持固定维度,更适合后者的工作。但一般的科学计算处理的矩阵很大,且不需要固定维度的支持。
我对机器学习库为何要支持固定维度有一些迷思。对于最早期的 MLP 与 CNN,一般模型会固定中间层或通道维度;CNN 中的卷积核一般是 或 维度,还具备个别维度小的特征 (但同时需要注意到,CNN 的卷积核参数还包括输入输出通道,如果两者都是 64 则张量大小至少是 ,这绝对不是小张量)。一些维度的固定是有助于编译器优化,也有助于 JIT 优化的;但在极限情况下,这些自动优化要么打不过手动优化,要么可以在动态维度的框架下对维度作判断并用 dispatch 的方式实现。
8.2. 张量 Layout 操作有哪些?对计算性能是否有损耗?
典型的 Layout 操作包括
- Basic indexing,即依照一定的规则取出子张量或子矩阵;但依情况也可能是增加若干维度;
- Transpose,即张量的若干角标的轮换;
- Reshape,即更改张量的形状。
这些 Layout 操作中,basic indexing 与 transpose 不会具体地改变张量的数据。对于 reshape,当张量底层的数据具有一定的连续性时 (这也是一般情况),也不会改变张量的数据;但张量的数据并非连续存储时,这要看情况了。
当不改变张量的数据时,layout 的操作是对计算性能没有损耗的。如果有损耗,很多时候也只是 10 个整数之内的复杂操作;这点操作相对于电子结构的问题是不重要的。我们需要强调我们做的是电子结构,因为我估计在有些领域里,有人是关心这一点点损耗的。
在 RSTSR 程序中,除了设计基于 layout 的迭代器之外,我们对 layout 运算 (包括但不限于 broadcast, split_at, translate_to_col_major 等) 完全不优化性能。该 clone 就 clone,该用堆就上 Vec<usize>,没有什么好客气的。
8.3. 张量迭代器是怎么设计的?
首先,我们实现的张量迭代器,都是基于 layout 迭代器而来的。张量如何迭代,取决于张量的 shape, stride, offset,而与张量的元素没有关系。因此,张量的迭代器与 layout 的迭代器要分开。
Layout 迭代器迭代的是张量的索引 (譬如矩阵就是二维 usize 数组 [i, j]),输出的是 usize 类型的该索引在内存的相对地址。基于此,张量的迭代器 (迭代的也是索引,但输出的是数值或其引用) 就很容易实现了。
在文件 layout/iterator.rs 中,我们实现了 layout 迭代器。其中一些要点是
- 写了 col-major 与 row-major 两种版本。Layout 的迭代不是一维数组的迭代,它可以有不同的顺序。对于 col-major 的迭代,由于变动最多的是首个指标,因此效率会高一些;不过这件事暂时没有用 micro benchmark 证明。在程序内部的算子实现上,我们基本始终使用 col-major 版本。
- 性能最关键的函数是
next_iter_index和back_iter_index。它将针对 1-D – 4-D layout 作手动展开,其余情况用循环实现。 - RSTSR 库允许固定维度与可变维度。迭代器在固定维度下的效率会高很多,这可能是因为静态维度下 shape 是用
[usize; N]实现,而动态维度是用Vec<usize>实现。在程序编译时,[usize; N]对编译器的性能优化更加友好。 - 迭代器是频繁的操作,需要高效率;在
next_iter_index和back_iter_index中,对迭代器内部的变量index_start与index_end的改动需要是 inplace 的,而不能 clone 一个出来。
在文件 feature_rayon/layout_par_iter.rs 中,我们实现了 layout 并行的迭代器。这基本上就是套公式。需要注意的是
- 我猜测只有实现了
IndexedParallelIterator,Rayon 并行的效率才能接近 OpenMP。
8.4. Elementwise 张量算子是怎么实现的?
Elementwise 张量运算包括四则运算、常用函数 (如 sqrt, sin 等等)。
对于四则运算,在 RSTSR 第一次报告小节 3.6 (pp 15–20) 有所提及。
这里拿另一个更直观一些的 sin 函数实现来举例。
-
RSTSR 的算子都尽可能分离前后端;具体地说,是 Tensor trait 部分、Device trait 部分、还是具体的 Device impl 部分。
-
RSTSR 的 trait 定义一般都有后缀
API,以与 struct 类型作区分。 -
Tensor trait 部分对 sin 函数的实现在 tensor/operators/op_unary_common.rs 中。sin 函数是单变量输入,因此称为 unary 函数。由于我们要实现许多单变量函数 (譬如 sqrt, log 等等),因此需要使用 macro_rules。Tensor 部分的 trait 应该保证任何后端都可以执行,即这里真的只是设计接口和简单的执行逻辑,真正的计算不应该在这里出现。
-
Device trait 部分是纯粹的接口。sin 函数的 trait 声明在 storage/operators/op_binary_common.rs 中。因为 sin 函数涉及到输入张量与输出张量,因此有两个参量参与;我们称其为 binary 函数 (这个命名原则很可能不好,这个以后可以改)。
-
Device impl 以
DeviceCpuSerial为例,实现在 device_cpu_serial/operators/op_binary_common.rs 中。我们注意到,实际上这里做的事情是impl<...> DeviceSinAPI<...> for DeviceCpuSerial {fn op_muta_refb(...) {self.op_muta_refb_func(..., |a, b| *a = b.sin());}}这里涉及到一个函数
op_muta_refb_func,它将转到真正用来作实际计算的代码op_muta_refb_func_cpu_serial中。该函数将读取输入张量的原始数据b: &[TB]和 layoutlb: &Layout<D>、输出张量的原始数据a: &mut [TA]和 layoutla: &Layout<D>,以及两者之间的映射函数f: impl FnMut(在当前的例子中是 sin 函数)。这么做是出于简化代码的目的,因为 unary 函数都有统一的实现策略。 -
具体计算的代码中,我们会调用函数
translate_to_col_major。其目的是,- 如果输入是 col-major 的张量,我们就按 col-major 作迭代;
- 如果输入是其他 major 的张量,那么我们就将它转置成 col-major 作迭代。用户只关心输出正确就行,那么我们未必要按照张量本来的迭代顺序执行。
-
后面还会调用一次
translate_to_col_major_with_contig,其目的是- 取出最大的连续维度长度。当张量有至少一个维度在内存中是连续时,我们把所有这些连续的维度并到一起,剩余不连续的维度打包到一块。举例而言,
- 如果 3-d 张量
a是在连续内存上声明的,那么最大连续维度长度就是整个张量大小,没有剩余不连续的维度; - 对于上述张量
a,取其中的 slicea[1:4, :, :],跟刚才一样是全局连续的; - 取 slice
a[:, 1:4, :],那么它有一个不连续维度,最大连续维度长度是后 2 维度的乘积; - 取 slice
a[::-1, ::-1, ::-1],它是逆向连续的,在这种情况下我们认为它是完全不连续的。
- 如果 3-d 张量
- 有内存连续时,采用标准库内置的连续迭代器是最快的;对于简单的四则运算 binary 问题,连续并行迭代器效率可能还不如连续串行迭代器;用 layout 迭代器只会拖累速度。
- 剩余的部分就用 layout 迭代器。
- 取出最大的连续维度长度。当张量有至少一个维度在内存中是连续时,我们把所有这些连续的维度并到一起,剩余不连续的维度打包到一块。举例而言,
总地来说,
- Tensor 与 Device trait 是用来定义运算的,这由张量库的核心设计 (但其他用户应该也可以实现,未来也有可能会将这些 operations 从 rstsr-core 核心库中分离出去);这些部分不负责计算,只负责接口。
- Device impl 部分可以由用户自己完成,他们可以在里面进行任何高性能的实现。
这个思路可以认为是仿照 burn 库的,但代码上没有参考过他们的库。
8.5. Transpose 和 Reshape是不是算子?
不是。它们算 Tensor manipulation。
并不是所有的张量操作都归为算子。
- 一些情况是组合算子,比如
exp(x) - 1。依情况,该组合算子单独作为算子实现 (为了更高的浮点精度或更高的性能),也可以就 naively 以exp(x) - 1实现。 - 像 transpose 确实不是算子。Tensor 分为具体的数据部分 (storage) 与 layout;transpose 仅仅处理 layout。Tensor 部分的接口在
into_transpose_f函数定义,而具体进行 layout 级别 transpose 的程序是Layout::transpose。 - Reshape 确实特殊一些,因为它有可能不需要新开辟内存存储张量,但也可能需要这么做。我们仿照 ndarray 的做法,实现
TensorCow类型;如果确需开辟一片新的内存,我们就需要使用算子 empty (empty_impl) 来声明一块内存、并用赋值算子 (assign_arbitary) 将原来的张量复制到新的张量中。Reshape 函数实际实现在程序change_shape_f中;但该函数一方面还可以进行优化、另一方面似乎逻辑太复杂而应该将其分离到 layout 部分。
8.6. BLAS 线程数要怎么控制?
RSTSR 在这方面学习了 rest_tensors;即使用 openblas_set_num_threads 来控制线程数量:
- 当在 Rayon 并行区域 (
rayon::current_thread_index返回数值时) 控制为单线程 BLAS; - 当在串行区域 (
rayon::current_thread_index返回 None) 回到多线程 BLAS;
这未必是最好的解决方案,但对于我们应该够用了。
不是最迫切的问题,但这样做会有其他一些细节问题:
- 上述实现策略似乎只在 pthread 编译的 OpenBLAS 有效;对于 OpenMP 编译的 OpenBLAS 则会产生问题;
- 该函数是 OpenBLAS 特化的,不能用在链接了 MKL 或 BLIS 的情况。使用该函数意味着绑定了 OpenBLAS。
我认为在 C/C++ 中,这类问题可以在头文件定义预编译宏 (#if(HAVE_OPENBLAS) 之类的),在实际使用时引入预编译判断实现 MKL 与 OpenBLAS 切换。这样的做法在 Rust 中不是不可以,但我认为可以换一种做法:设计两套后端,DeviceOpenBLAS 与 DeviceMKL。两套后端使用两种不同的线程控制策略。在电子结构程序中,则定义通过预编译宏 (在 Rust 中是 cargo features),定义默认的 DeviceBLAS 是 DeviceOpenBLAS 还是 DeviceMKL。