RSTSR 第三次报告
RSTSR 第三次报告:AI 时代下的 Rust n-维张量科学计算库 -- 进展、变化、未来
RSTSR 自 2024 年 7 月第一个 commit 以来,已经历时两年。
我们现在终于到了阶段性的里程碑:CPU 下高效的、原生 Rust 的、与 NumPy 接口高度兼容的 n-维张量科学计算库。
我们已经认为,CPU 下的 Rust n-维张量科学计算库的初步目标,对于原子轨道基电子结构程序的基本需求而言,已经达成 (请留意 RSTSR 尽管有较大的目标,它仍然服务于是电子结构程序的子项目)。
1. RSTSR v0.10 进展:全面兼容 Python Array API 2025
1.1 兼容 Python Array API
RSTSR 作为原生的 Rust 库,它实现了几乎所有 Python Array API 2025 标准的接口。RSTSR 不再是“受 Array API 启发”,而是真正实现了 Array API 标准的非 Python 程序库。
-
证明:基于 RSTSR v0.10.0、Faer 后端的的简单 Python 封装程序 rstsr-faer-py 可以在 PyPI 上下载;对 Array API 2025 测试套件 结果是 1336 Pass / 17 Fail / 33 Skip (对比 NumPy 2.5 的结果是 1339 Pass / 42 Fail / 5 Skip)。其中,14 Fail / 33 Skip 是测试套件自身、以及 RSTSR Faer 后端未实现 FFT 功能;其余 3 Fail 是实际应用情景中罕见的 SVD 浮点数过大溢出问题。可以表明 RSTSR 除 FFT 功能外,正确实现了所有 Array API 2025 的接口。
-
几乎:所有重要的接口都已经实现,只是少量接口因 Rust 语言本身的特性难以或不可能实现。这些被排除的功能包括
- Python 中允许的
__ipow__,__imatmul__,但 Rust 不存在 (但可以用函数实现的) 的运算符重载; - Python 允许的动态类型列表,但 Rust 通过静态类型实现非常困难;受到影响的函数包括
concat,stack(但只要是相同类型的张量,RSTSR 仍然可以使用rt::concat和rt::stack)。
- Python 中允许的
1.2 更强可读性的代码
这里明确提出一种可能反主流的看法:Rust 的编写可以是非常简洁的,是适合科学计算程序开发的语言。
RSTSR 本身的代码可能并不简单,特别是有大量复杂的 trait bound。但 RSTSR 的用户接口非常简洁。
实现所有 Python Array API 标准功能意味着我们支持 NumPy 中许多高级的、通常线性代数库所不具备,但对编写程序又大为方便的功能。
NumPy 经常以方便易用为人称道。我们指出,NumPy 可以用一行代码或声明完成的功能,RSTSR 通常也可以用一行代码或声明完成。我们不打算在这里详述所有 RSTSR 的功能;熟悉 NumPy 的用户,可以参考 RSTSR ↔ NumPy cheat sheet。这里强调电子结构程序所常用的一些功能。
对于电子结构程序,最关键的高维张量库的高级功能,是基础索引 (basic indexing)、张量形状重塑 (reshape) 与广播 (broadcasting)。
基础索引是取子矩阵/张量,但 不复制数据;合理的基础索引所导出的矩阵是可以直接代入 BLAS/LAPACK 计算、而不需要额外的内存开销的。基础索引通常用于对大型张量中切出小矩阵作计算或赋值。
| NumPy | RSTSR | 描述 |
|---|---|---|
a[2] | a.i(2) | 对单个轴索引 |
a[:, 3] | a.i((.., 3)) | 对第二根轴索引 |
a[2:6] | a.i(2..6) | 对单个轴切片 |
a[0:2, 2:4] | a.i((0..2, 2..4)) | 对多个轴切片 |
a[..., -1] | a.i((Ellipsis, -1)) | 对最后的轴索引 |
a[:, None] | a.i((.., None)) | 增加新的轴 |
a[2:10:2] | a.i(slice!(2, 10, 2)) | 步长切片 |
a[::-1] | a.i(slice!(None, None, -1)) | 反向切片 |
a[:, 3] = b | a.i_mut((.., 3)).assign(&b) | 对可变视窗写入 |
Reshape 函数则经常用于在稠密高维张量操作时,零开销地转换为矩阵问题;或在读入连续内存数据时,将其重新布局为高维张量。
| NumPy | RSTSR | 描述 |
|---|---|---|
a.reshape(3, 4) | a.reshape((3, 4)) | 输出 TensorCow (占有或视窗数据) |
a.reshape(3, 4).copy() | a.into_shape((3, 4)) | 输出 Tensor (占有数据) |
a.reshape(-1) | a.reshape(-1) | 平铺数据到一维 |
a.reshape((3, 4), order="F") | a.to_layout([3, 4].f()) | 依 Fortran 连续重新布局数据 |
电子结构程序偶尔会使用到高级索引 (advanced/fancy/array indexing)。高级索引可以用于后自洽场方法的冻结轨道处理,占据轨道选取,或在计算中对张量的某些维度进行随机采样。
| NumPy | RSTSR | 描述 |
|---|---|---|
a[[0, 2, 4]] | a.array_index([0, 2, 4]) | 在第一根轴依列表取数据 |
a[[0, 2, 4], [0, 1, 2]] | a.array_index(([0, 2, 4], [0, 1, 2])) | 在第一、二根轴取数据 |
a[[0, 2, 4], 1] | a.array_index(([0, 2, 4], 1)) | 混合基础索引与高级索引 |
a[:, [1, 8, 7]] | a.array_index((.., [1, 8, 7])) | 混合基础索引与高级索引 |
1.3 一年来的重要功能改进
- 更好的零开销 reshape 支持。零开销的 reshape 函数一般要求输入张量有足够的内存连续性,此前的 reshape 需要足够强的 c/f-contiguous 内存布局;现在的 reshape 可以在更宽松的条件下进行。
- 更好的 column-major 支持。RSTSR 默认是 row-major 的;但 RSTSR 在电子结构程序 REST 的实际应用中使用 column-major 内存布局。为此,我们使用了与 row-major 不同的 broadcast 与 reshape 规则,更好地支持 column-major 内存布局的张量操作。详细见 Row/column-major order semantics。
- Einstein Summation 支持。在外接 TBLIS 张量缩并库的情况下,RSTSR 可以使用与 NumPy 相同的 Einstein Summation 语法进行张量缩并计算。详细见
rt::tblis::einsum。 - 高效的 Vecdot 支持。对于电子结构,特别是一部分稠密 DFT 矩阵计算,
"pi, pi -> p"类型的张量缩并非常常见,且确实是不小的内存带宽耗时瓶颈。我们对rt::vecdot函数的实现并非是 naive 的;它在多核并行下性能优秀,比单纯的矩阵数乘后再求和要快许多,且内存开销更小。
这些是 Array API 标准所不具备或不要求、但对 REST 电子结构程序开发重要或有潜在价值的功能。对于 Array API 标准所要求的部分,我们也进行了诸多实现与改进,特别是诸多线性代数函数的封装与实现 (SVD, QR, pseudo-inverse 等)。
1.4 既有功能重述
这里重新介绍一些早期版本就已经有的功能。它们同样是 RSTSR 的重要支柱,是我们区别于其他 Python 或 Rust 高维张量库的特色,但并不在最近的进展中有重要更新。
- 优秀的并行管理:针对多线程 BLAS 后端,我们通过 rayon 的线程控制,可以保证无论是否在 rayon 并行线程内部还是外部调用 RSTSR 的通用计算或矩阵线性代数,都能充分利用并行设备优势、且不会超出用户所指定的线程数。
- 同时支持 row-major 与 column-major:RSTSR 默认支持 row-major 内存布局;但我们同时允许 column-major 内存布局,且在现实项目 REST 电子结构程序中已经大量使用。
- 支持多种 BLAS 后端:RSTSR 可以使用 OpenBLAS、Intel MKL、BLIS、TBLIS 等多种 BLAS 后端;在 CPU 下的性能表现与 NumPy 相当。支持如 solve, svd, eigh 等矩阵线性代数运算。
- 可扩展后端:我们采用泛型以支持多后端。用户不需要修改 RSTSR 的源代码,不需要要求数据在内存 (GPU/硬盘/网络都可以承载数据),只要实现新的后端 trait 接口,就可以使用自定义后端实现数学计算。
- 支持多种数据类型:RSTSR 支持通常浮点数,也支持任意数据结构 (包括字符串等需要 alloc 的类型);在电子结构程序中,f64 与 c64 是最常用的数据类型,我们对这些数据类型进行了支持和特殊优化。
1.5 代码增长情况
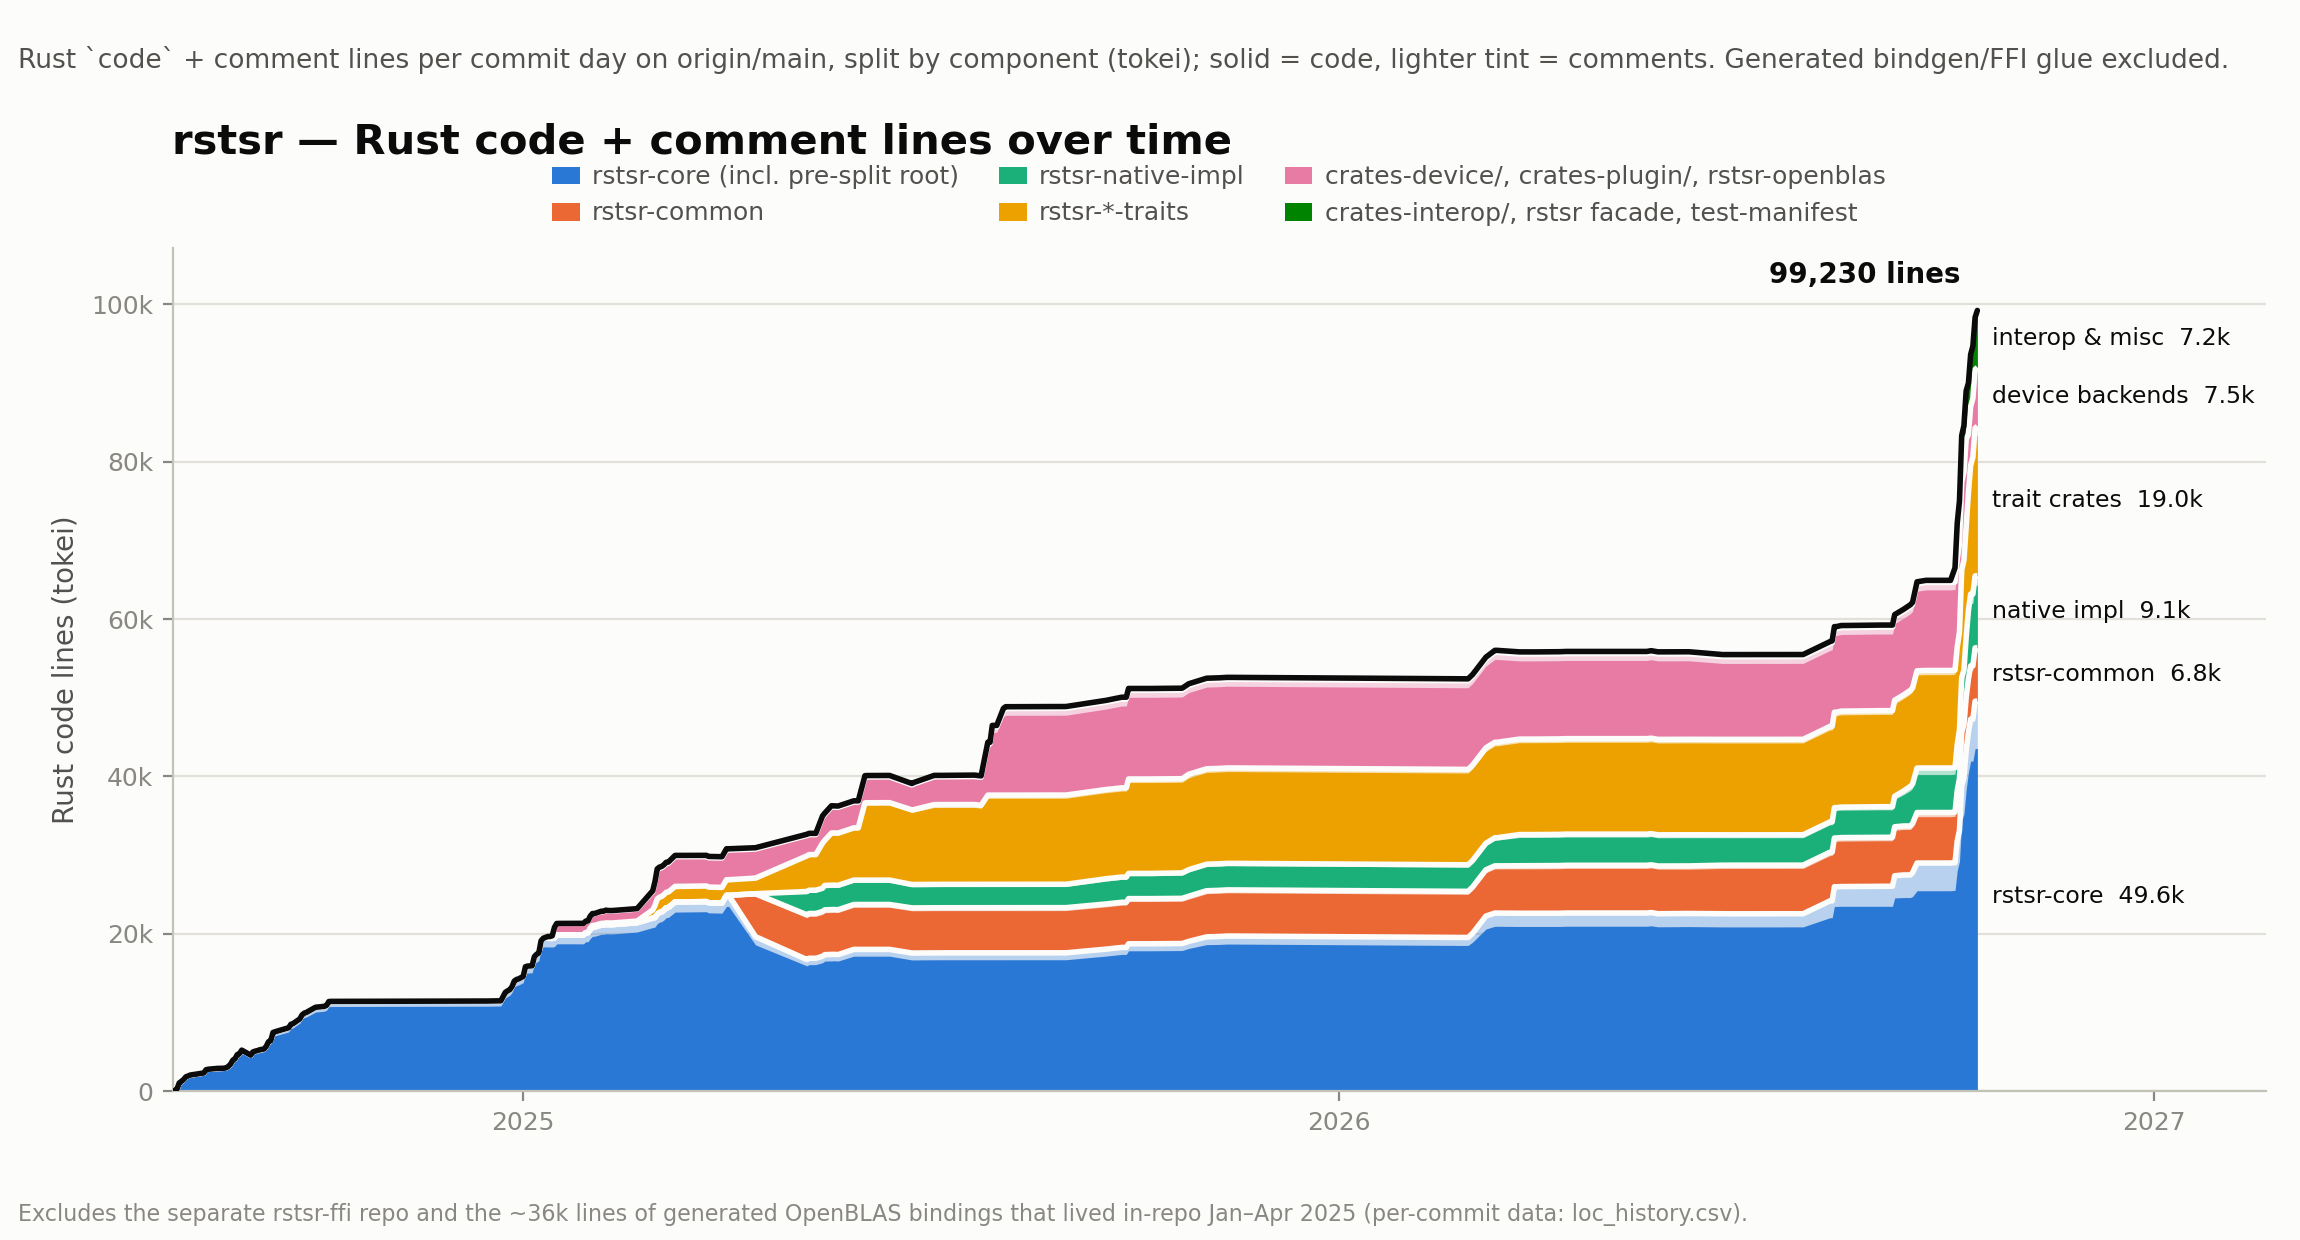
RSTSR 的代码在很长一段时间维持在 50k-60k 级别。我们当然不能说代码量越大越好,特别是 AI 辅助开发的时代,代码量的增长并不意味着开发者的工作量增加。可以看到,在 AI 辅助代码密集进入的情况下,两周时间,非 FFI 代码量从 65k 增长到 100k。这些并非是无意义的代码生成,是实打实的功能更新。
1.6 对 Python Array API 的碎碎念
我们要这么复杂的 DType Cast/Promotion 干什么...留俩重要的得了...
2. RSTSR 在 REST 中的进展:更高性能的热化学性质计算
2.1 性能展示
一个典型的示例是,我们在 REST 电子结构程序中,实现了高效的杂化泛函二阶解析梯度 (REST PR !154)。
Hessian 二阶解析梯度可以给出重要的化学性质,包括分子振动频率、热力学能;其衍生量可以给出红外光谱、拉曼光谱。它在谱学与热化学上有重要的应用价值,可以服务于药物设计、材料设计等上位学科任务。
在 20 原子 def2-TZVP 体系上,我们的程序在 B3LYP 杂化泛函下,以 Intel Skylake 36 cores 并行下,可以在 130 sec 完成频率计算。该耗时媲美同类闭源程序 ORCA,相比于同类开源程序与以頭文字 G 为代表的闭源程序快数倍。放大到更大的体系上,我们能表明 REST 程序在 RI-JK 近似下的 Skeleton 导数达到相当高的性能,在 CP-HF 求解过程的 FLOPS 利用率到 40% 以上,同时在算法实现与程序优化上有出色的表现1。而这些是基于 RSTSR 的高效张量计算实现的。
2.2 RSTSR 对实现电子结构算法的支持
以 DFT 二阶梯度为例,部分的公式表示与程序实现说明,可以参考 REST 开发者手册。对应主要程序在 hess_rks.rs。
显然 DFT 可以通过稀疏性进行性能优化;这里我们不讨论稀疏性优化,我们指出 RSTSR 能在相当短且直观的代码里,高效地实现各种稠密矩阵算法。
-
对 "pi, pi -> p" 类型的高效缩并。我们在实现密度格点的计算时,经常会遇到下述问题:
而在能量导数贡献量计算时,也会经常遇到类似的问题:
这些不是简单的矩阵乘法实现,也不适合用矩阵数乘后求和实现;它们实际上是一步到位的计算过程。在 RSTSR 中,其对应的实现分别是
rt::vecdot(a, b, -1)与rt::vecdot(a, b, -2)。这极大减少了内存带宽瓶颈代码的耗时。 -
原地矩阵乘法。尽管 RSTSR 具有非常方便的矩阵乘法语法糖 (使用
%作矩阵乘法);但这会产生额外的内存开销。对于 DFT 中频繁的矩阵操作,更合适的做法是使用原地矩阵乘法c.matmul_from(a.t(), b, alpha, beta)以达到 的效果。在矩阵乘法中,即使输入矩阵有转置,我们也会在后端选择合适的 BLAS 指令来零额外内存开销地实现计算。我们并没有在当前的 DFT 二阶梯度程序中彻底贯彻减小一切频繁内存声明与释放的原则,但程序框架上至少是能保证这一点的。 -
零开销高维度索引。在电子结构程序,特别是梯度相关程序,我们对基础索引的灵活程度要求非常高:
-
DFT 的开壳层二阶梯度计算中,我们会处理含有两个自旋、两个导数分量、一个格点指标的 5-dim 张量 。
-
在分摊特定原子对 Fock 矩阵贡献 时,我们需要同时对四维张量 作最连续与最不连续维度的切片;这个原地累加过程不会出现新的内存开销:
// F [mu , nu, t , A] -= T [mu , nu, t ]*&mut f.i_mut((slc, .., .., A)) -= t.i((slc, .., ..));
-
-
方便有效的 unsafe mut。Rust 语言本身对并行的可变引用有严格的限制;如果我们追求严格的安全代码,程序有可能会变得不直观。如果我们在 C/Fortran 中习惯使用
#pragma omp shared,那么我们在 RSTSR 中允许使用unsafe tensor.force_mut()同样地获得并行区域的可变引用。用户可以自己通过线程锁作类似于#pragma omp critical的处理。let guard = Mutex::new(());let result = rt::zeros((shape, &device)); // 创建结果张量chunks.into_par_iter().for_each(|chunk| {let result_part = ...; // 计算部分贡献unsafe {let _lock = guard.lock().unwrap(); // 获取锁*&result.force_mut() += result_part; // 累加结果// Rust 的作用域管理会自动释放锁}})同理,如果用户可以保证写入张量不存在竞争,那么也可以用
force_mut来获得可变引用而不需要锁。总之,在并行区域想要获得可变引用,用户只要保证不会竞争,剩下的交给
unsafe force_mut即可,不需要更复杂的同步机制。而这些保证在非 Rust 语言同样是需要用户明确需要考虑的,Rust 并没有增加更多的语言障碍。 -
简单的线程并行。我们会注意到,在
hess_rks.rs整个 DFT Skeleton 导数实现中,只有一处使用了 rayon 并行语句chunks.into_par_iter().for_each()。-
一来,如果这里使用串行
chunks.for_each(),我们仍然会注意到 RSTSR 会以相同的用户指定核数并行;只是并行逻辑不同,所有单步张量操作都会使用 RSTSR 的并行。这可能对缓存并不友好,因此运行效率会有所降低,但不会出现不使用 rayon 并行框架就无法利用多线程优势的情况。
-
二来,RSTSR 的特性保证在 rayon 并行区域内会使用相对高效的串行代码,将并行交给 rayon 线程池。
串行与并行的代码并没有本质差别。对于 RSTSR 框架,编写串行代码后,不需要作更多适配,可以在外部直接套用 rayon 即可。不会出现使用 rayon 并行框架后线程超支 (thread oversubscription) 的问题。
-
3. AI 时代下的 RSTSR:开发者的个人偏好说明
AI,特别指大语言模型,在 2026 年这个时间点,时时刻刻对我们的现实生活与认知产生冲击。
许多我们相信的事物、历史进程中认可的规律和共识,变得不再可靠。我作为 RSTSR 的开发者并不例外。我随时可能更新这里的看法,但这里记录我目前诚实的思考。
3.1 AI 工具在 RSTSR 的使用与历史
我个人会粗略地将 AI (特指基于 Transformer 的大语言模型) 自划时代的 GPT-3.5 到现在的时代 (其实也就 4 年不到),分为下述几个阶段:
- 难以用于程序开发阶段 (2022/12-2025/01):标志性模型 GPT-3.5。这一阶段模型思考与对齐能力弱,常识性问题的回答上正确性堪忧;但已经展现出惊人的模型知识储备、以及一定程度的理解与输出能力。
- 弱编程辅助阶段 (2025/01-2025/11):标志性模型 Deepseek-R1。这一阶段模型已经具有较强的世界模型能力与对齐能力;依靠逻辑思考链,可以应对相对复杂的编程语言迁移任务。这一阶段没有真正形成自然语言编程,生产环境下的程序仍然必须由程序员主导、在 IDE 实现。
- 强编程辅助阶段 (2025/11-):标志性模型美国 Claude Opus 4.5,中国 GLM-4.7。标志性辅助工具 Claude Code。这一阶段自然语言编程逐渐成熟;大量真实项目的程序开发模式转变为 AI 编程、人类架构。毫无编程经验、但有测试能力的开发者,可以使用 AI 工具实现开发任务;大型项目维护、长期项目维护与非常见代码仍然必须由有经验的开发者完成。其带来的间接结果是 OpenClaw 热,破圈到其他行业积极投入 AI 使用。
- 智能开发阶段 (2026/09-):标志性模型 GPT 内部数学模型。我们见证了 GPT 在 2026/08 对数学界的冲击。我认为与人类不同、且很可能在未来被认为是相比于人类更高等级的智能已经或接近出现。这一阶段对程序开发的影响尚未可见,这是由于未流入流通市场的模型无法被广泛使用与理解,程序群体无法形成新的共识。但对数学界的冲击这件事本身已经促成几乎所有开发者对强程序辅助的共识:AI 可以、且经常能在较高的层级上托管程序开发任务。
RSTSR 程序在弱程序辅助阶段,曾使用 deepseek-coder 模型转译 LAPACKE 代码 (现在 RSTSR 的 driver_impl 模块的代码前身),以在没有 LAPACKE 符号的情况下实现 row-major 矩阵的 LAPACK 调用。同时,在 2025/08,为支持 einsum 函数在 Rust 语言下的实现,缩并路径优化器 opt-einsum-path 也使用了 Deepseek 模型辅助了 Python 代码进行迁移与优化。当时的辅助通常是 AI 生成代码后,人工在 VSCode 中逐行审核、修改、编译通过。
在强程序辅助阶段的早期,由于我当时着重于完善 REST 电子结构程序的 FFI 层面基础 (2026/01-2026/03)、naive batched DFT 格点积分程序 (2026/05)、RI-JK/DFT Hessian 计算 (2026/05-2026/06)、DFT grid-shift 贡献与文档记录 (2026/07-2026/08)、实现 DH 一阶梯度 (2026/09) 功能,这一阶段并没有在 RSTSR 上有较大的尝试。我认为,除了 FFI 部分,电子结构程序需要一定架构基础与公式理解基础、有性能要求,且一些程序先前并没有高效的程序实现 (没有合适的借鉴对象),当时的国内模型能力也尚欠火候,导致 AI 在这些电子结构程序的开发中经常无法提供充足的帮助;这与许多框架明确、类似实现较多、语料充足的程序情况不同。不仅需要人直接主导架构本身,也需要人的大量的直接代码编写过程。
而在 2026/08-2026/09,中国国内模型 GLM-5.3-flash 与 deepseek-v4.1-flash 的出现,标志了国内模型在可接受的 token 价格 (远低于 Kimi-K3) 下,强编程辅助能力与美国模型真正接轨。但即使如此,在实现 DH 一阶梯度 (REST PR !264) 时,我的感受是,即使 AI 能主导程序的代码生成并加快开发进度,但仅靠清晰的 prompt、外加多套原型程序实现、外加清晰的技术路径,若不审核代码、且对 AI 的实现路径作修正,仍然会难以达到优秀的程序性能与可维护性,甚至存在反向性能优化的可能。
RSTSR 作为功能明确的、一定程度上作为 NumPy 功能到 Rust 的迁移工作,本来也是比 REST 电子结构程序 更适合 AI 辅助开发 的项目。也因此,在此期间,我开始了相对大刀阔斧的 AI 辅助开发。
在 2026/09 期间,我们对 RSTSR 库中 soundness 存在问题的部分作了修正。现在的 unsafe 至少有 AI 的辅助矫正作为参考,解决了大量 miri UB 警告。至此,RSTSR 已经经过一次相对完整的正确性验证。
在 2026/10 上半月则是对功能进行完善。这一次的 AI 辅助开发目标非常明确:实现 NumPy 功能与编程习惯在 RSTSR 上的迁移,并以 Python Array API 2025 为标准表明迁移的完成程度。由于先前 pre-AI 时代已经搭建好比较清晰的框架,参考程序 NumPy 与 Array API 的测试也相对全面和高质量,我与 AI 的协同工作效率相当高。我仍然每次都是手动开启 session,并非让 AI 全自动完成。但同时这次的代码增加非常激进,我已经开始不逐行审核代码了;对于看过去行为大致正确、测试函数大致正确、AI code-review 进行过一轮的情况,会直接合并。
历史只能说明既往的经验,殇叹一些不再存在的东西。我们会认为,AI 辅助工具,至少仅谈论 RSTSR 本身的开发上,会有相当大的帮助;且在程序框架可控的前提下,未来很可能会更大量地使用。
3.2 为何我坚持发展可读性好的框架?
工程问题是基于 理解 前提下的 妥协
我始终认为,理解是重要的前提。但 AI 时代下,或者说所有时代下,我们要对工程问题的理解精细程度要到哪一层?如何合理地妥协、如何随发展力的变化而调整是重要的问题。
妥协是以目标为前提和导向的。我打算发展 RSTSR 是以如下目标为导向的:简化电子结构程序本身的复杂程度,而不对性能作过多妥协;但为此增加基础数学库本身的复杂度是可以接受的。
科学计算程序的复杂性至少来源于三方面:
- 对公式的正确解读、以及将其内化到程序的正确实现上;
- 在有限的计算资源下,合理选择数据结构与算法;
- 在给定的算法下,充分使用硬件与程序技巧加速计算。
如果事事都要操心,那么我们的注意力势必会分散,无法在有效的注意力窗口中做更多的事情。
不同的人所被要求的妥协层次是不同的:科学计算程序员会在第二与第三层之间妥协;而算法与性能工程师则必须要仔细地对第三层作处理、但他们不需要对第一层的科学问题有深入的理解。
科学计算的服务对象是科学技术工作者,他们必须要保证程序的正确性和可靠性。因此,这个妥协的平衡会放在第一与第二层之间:即使 AI 可以辅助,但科学技术工作者有责任确认与理解程序本身,而剩下的问题无论多重要也可以是次要的。当然程序也是有高层用户接口级别与底层硬件级别的差异化;在一个良性发展的梯队中,高层级的问题应该要有办法能信任低层级的处理。
科学问题的公式与方法,自然语言下无论描述得多精确,也不能与可以正确执行的程序等价。即使是 AI 已经有重大突破的数学领域,即使我们通常会假定 Lean4 的编译与对形式化后的表达式验证都是正确的,人为地检查 Lean4 代码目前仍然认为是必要的。这对于科学计算程序想必也是类似的。科学计算与数学又稍有不同:数学的结果通常就是证明或证伪;但科学或技术问题、特别是新的问题,没有对应的严格正确的数值,缺少人为验证的环节通常是不合适的。对于老问题,有正确程序结果验证的情况下可以跳过;但对于还希望在发展新方法、面对新问题的学者,理解程序与科学技术问题的映射关系仍然是不可或缺的。
不论人工智能多强、是否有意识、是否能进行科研创新,它们都无法替代我们自身对科学问题的理解与实践。这与一个优秀的学者,不论多么权威,都无法替代我们自己对学科的发展下判断,道理是类似的。人与人之间有沟通成本;在 AI 时代下,我们至多会注意到人际沟通成本可以降低,但不可能归零。
就我自己而言,早先发展 RSTSR 的其中一个很重要的目的,是发展一套容易编写的科学计算程序的框架。在强编程辅助的 AI 下,我们通常已经不再指望程序一定要自己编写了。但从根本上,之所以要发展容易编写的程序框架,也是为了在人脑有限的精力里,更有效地用我们自身对科学或技术问题的理解;这个需求总是存在,因而一个简化的、可运行的框架总是重要的。况且 Rust 在语言特性与性能上都有优势,开发 Rust 语言下的科学计算库一定程度上是双赢。
这也是我在发展 RSTSR 上倾向于不妥协的地方之一:RSTSR 应该要是有优秀可读性的、直观便于理解的代码框架。NumPy 实际上已经是非常优秀的框架、或者说目前还没有其他框架对 NumPy 作替代与革命。我认为 Rust 语言同样可以胜任,同时还兼具性能与安全性优势;并没有编译语言、静态语言就一定比 Python 更难达到高可读性的说法。我想这个项目现在的进度已经证明了这件事。
3.3 为何我们决定不使用自动 agent 流程?
我们指出,RSTSR 未来很可能会在更大尺度上使用 AI 辅助开发。但我们目前仍然坚持人工主导的开发模式。
我目前认为,随着 AI 能力越来越强,编程模式会向两极分化:在相对清晰的指令下,要么 AI 能保证完成,要么由于各种原因 (短上下文、非常见框架、未有前人实现而世界模型没有任何先验知识) 而必须由人提供全部或部分代码 (古法编程)。AI 能保证完成的比例应该是很高且甚至还在不断增长的;但为了相对而言很少的情况、以及作为教学的目的,我们仍然需要保证我们作为人类有能力完成开发任务。
RSTSR 的开发,至少在用户接口层面,仍然由人提需求,经过必要的接口部分与测试部分的审核。这意味着 RSTSR 项目在使用上必然是人可以接受的、且至少符合 RSTSR 开发者作为人类的开发习惯与审美,以保证可读性。我们认为,RSTSR 的具体实现一般不暴露给用户,因此具体实现的代码可以一定程度上放手。
我们说 RSTSR 并不采用自动 agent 流程;但何谓自动?如果一切都可以自动化,那么我们为何不一步走到全自动资本主义?如果我们眼中的世界只有算法实现,那么现在 RSTSR 的开发模式确实是自动的:它们在一些黑箱的、我们不会真正阅读的 subagent 中运行。对于未来可能引入的 GPU 实现,这更可能是如此:大多数常用的用户接口已经在 CPU 下有合理的定义,不涉及到 host/device 与 streaming 的问题很可能就全盘托付给 AI 实现与测试,而只会在有余力和人手的情况下作算法审视与理解优化。但如果我们眼中还有用户接口,那么 RSTSR 目前的开发模式就不算作是自动的,我们仍然需要在 AI agent session 中一点一点用 prompt 提需求、厘清思路与实现。
在有些人看来,非全自动 agent 的流程也是应该被扫进故纸堆的古法编程。我认为,这取决于我们打算在哪里妥协,打算在哪里信任,打算在哪里建立我们自身的理解与判断。
4. RSTSR 近未来版本的演进方向
4.1 通用 GPU 后端
在 CPU 接口可以大体固定、且有相对合理的测试条件下,GPU 后端将是非常机械性的工作。如上所述,如果只是实现既有的接口,我们很可能会全盘交付给 AI agent 来实现与优化。
GPU 相比于 CPU 最大的差别,可能在于 通讯。GPU 存在 host/device 通讯、GPU 内部互联、对 DRAM 有页面缓存要求、stream 异步等等。通常这些并非是张量库本身希望处理的,但它又与数据结构本身耦合,因此高性能的代码编写一般需要显式地考虑这些问题。在这方面,我们需要向前辈 PyTorch/CuPy/Burn 学习。但这些同时是设备专有的,大多数情况下不需要在 rstsr-core 核心层面处理。我们一方面需要充分考虑这些要如何在 GPU 后端实现中体现,另一方面也会考虑是否要向 rstsr-core 增加一些可选实现的 trait,以便总结和抽象出共同的高维张量通讯基础接口。
同时,一些 CPU 专有 (DeviceAPI<Raw = Vec<T>> 即数据使用普通向量存储的情形) 的函数,GPU 上会全部失效。我们可能需要考虑如何 (或甚至是否) 要填补这些空缺。我们在 CUDA/HIP 上的实现路径很可能会优先依 NVRTC 形式开展而不采用 CubeCL。
除此之外,CPU 下原生容易实现的算法,GPU 下会出现困难。很多时候,我们未必能完全指望单一数学框架能解决所有科学计算问题。我们始终要做好回退到非数学库框架的纯 GPU 后端实现。
但也指出,RSTSR 是非常灵活的可扩展张量库框架;实现两种技术路径独立、相互独立不冲突甚至兼容的 CUDA 后端,是完全可行的。这与目前不少主流的机器学习框架 (如 candle) 不同,它们通常对后端设备采用 Enum 而非泛型,导致所有后端实现都必须由开发者自己完成,无法进行扩展。
考虑到 GPU 的使用学习成本偏高,CPU 上负有经验的科学家未必能立即适应 GPU 编程。在上述工作完成后,我们也可能需要准备合适的文档 (也需要依 AI 的发展情况和我们的能力与理解力而变化)。
4.2 对线性代数与常见科学计算功能的补充
目前 RSTSR 尚未实现 SciPy 所支持的所有 linalg 函数、以及其暴露的一些 Lapack 接口。这包括一些高级的 pivot 函数。
RSTSR 有考虑、但未必会支持所有 SciPy 的其他功能,包括优化、矩阵函数求解等功能。以 Newton 函数矩阵求解为例,几乎所有电子结构程序都会有其特有的 Krylov 求解器;使用 SciPy 默认的求解器经常会导致三四倍的迭代次数,而精度还未必能保证更高。很多电子结构的数学问题都是特殊化的,如果我们的目标导向非常明确是电子结构程序,那么 SciPy 的高级功能反而不是张量库目前最立即需要支持的,而是应该交给电子结构程序自己处理。
4.3 文档编写
我编写 RSTSR 的一个重要的目的是更好的程序可读性。
但“可读性”并非仅仅由代码构成;代码 API 文档、用户文档、甚至实现决策,都是重要的补充。
目前我们在文档编写上人手并不算充裕,且在真实的科研压力下,我不相信包括我在内的任何人,真的愿意抽身做这些工作。但文档面向的对象是人;如果不是非常机械的文档内容 (我认为 API docstring 是相对机械的),那么文档的美感和节奏仍然需要由人来把控。
我们在 API docstring 上已经采用大量 AI 辅助;但目前仍然未更新用户文档。我们有可能会在未来,对 API docstring 的生成 skill 作修订,以及用户文档中 AI 的介入到底到什么程度是合适的。
4.4 社区化
我相信 RSTSR 具有很大的潜在使用群体。我不清楚是否是我的错觉,但我个人确实需要一个便于科学计算的张量库,而 Rust 能同时提供简洁安全的语法与高效的性能。
但我对于是否开放社区、是否以及如何宣传与推广,没有概念与经验。我对此抱持开放态度。